


Samsa Benchmarks
Benchmark vectorisation : quelle IA transforme une illustration en SVG éditable ?
Le benchmark vectorisation de Samsa mesure la capacité des modèles IA et des outils de vectorisation à transformer une illustration matricielle en SVG qu'un designer peut retoucher. Chaque participant reçoit le même prompt et les deux mêmes images. Chaque résultat est noté sur la fidélité à l'original, la structure (des calques nommés et complets) et le détail des zones clés. Le coût et la durée par image restent à côté du score, jamais dedans, et les valeurs brutes sont publiées.
Classement
| 1 Claude Opus 5.5 · max Agentique | 82.1 | 78.5 | 92.1 | 70.6 | passé | max | $51.9 | 118 min |
|---|---|---|---|---|---|---|---|---|
| ||||||||
| 2 Claude Sonnet 5.5 · xhigh Agentique | 79.5 | 76.0 | 89.2 | 68.8 | passé | xhigh | $32.8 | 92 min |
| ||||||||
| 3 Claude Opus 5.5 · xhigh Agentique | 78.4 | 72.6 | 90.7 | 68.8 | passé | xhigh | $30.9 | 84 min |
| ||||||||
| 4 Claude Opus 5.5 · high Agentique | 78.2 | 71.7 | 91.8 | 68.4 | passé | high | $22.9 | 76 min |
| ||||||||
| 5 GPT 6.1 Sol · xhigh Agentique | 73.9 | 64.0 | 89.0 | 73.1 | passé | xhigh | $8.0 | 75 min |
| ||||||||
| 6 GPT 6.1 Sol · high Agentique | 73.3 | 60.8 | 91.1 | 73.1 | mixte | high | $5.9 | 56 min |
| ||||||||
| 7 Claude Sonnet 5.5 · high Agentique | 72.7 | 65.2 | 88.2 | 61.3 | passé | high | $14.3 | 53 min |
| ||||||||
| 8 † (Balade en vélo électrique : une exécution exploratoire de l’essai A/B, pas une exécution propre du protocole (exécutée avec une version antérieure du prompt, interrompue une fois puis reprise, travail délégué à des sous-agents et sur une version antérieure de l’agent). Elle est classée comme tout autre résultat ; une répétition selon le protocole est en attente.) Claude Fable 5.1 · xhigh Essai A/B: Balade en vélo électrique : une exécution exploratoire de l’essai A/B, pas une exécution propre du protocole (exécutée avec une version antérieure du prompt, interrompue une fois puis reprise, travail délégué à des sous-agents et sur une version antérieure de l’agent). Elle est classée comme tout autre résultat ; une répétition selon le protocole est en attente. Agentique | 72.6 | 66.4 | 85.9 | 61.9 | mixte | xhigh | $79.8 | 92 min |
| ||||||||
| 9 Claude Opus 5.5 · medium Agentique | 72.5 | 64.2 | 88.3 | 63.1 | passé | medium | $13.1 | 62 min |
| ||||||||
| 10 GPT 6.1 Sol · medium Agentique | 68.4 | 53.7 | 88.5 | 70.6 | mixte | medium | $5.2 | 52 min |
| ||||||||
| 11 GPT 6.1 Sol · xhigh Single-shot | 48.8 | 15.1 | 87.2 | 67.5 | échoué | xhigh | $0.34 | 13 min |
| ||||||||
| 12 Recraft Vectorize Outil | 47.6 | 70.4 | 6.3 | 68.1 | mixte | — | $0.01 | — 3 (non chronométré) |
| ||||||||
| 13 GPT 6.1 Sol · medium Single-shot | 47.3 | 15.4 | 86.9 | 68.1 | échoué | medium | $0.17 | 5.4 min |
| ||||||||
| 14 vtracer 0.6.15, default settings Outil | 43.4 | 68.9 | 2.5 | 53.8 | mixte | — | $0.00 | 0.1 min |
| ||||||||
| 15 Claude Opus 5.5 · medium Boucle fixe | 38.2 | 4.0 | 84.4 | 44.4 | échoué | medium | $1.8 | 11 min |
| ||||||||
| 16 Claude Fable 5.1 · medium Single-shot | 37.4 | 3.1 | 80.8 | 48.8 | échoué | medium | $0.94 | 3.4 min |
| ||||||||
| 17 Claude Opus 5.5 · medium Single-shot | 34.5 | 0.0 | 80.0 | 42.5 | échoué | medium | $0.33 | 2.8 min |
| ||||||||
| 18 Arrow 2 Telos, Extra High Outil | 34.3 | 9.3 | 53.9 | 71.9 | échoué | — | ≥ $0.35 1 (borne inférieure : le coût réel est égal ou supérieur) | — 3 (non chronométré) |
| ||||||||
| 19 Claude Sonnet 5.5 · medium Boucle fixe | 32.8 | 4.5 | 74.8 | 29.4 | échoué | medium | $0.38 | 3.7 min |
| ||||||||
| 20 Claude Haiku 5.5 · medium Single-shot | 31.6 | 0.2 | 77.0 | 30.6 | échoué | medium | $0.01 | 1 min |
| ||||||||
| 21 Claude Sonnet 5.5 · medium Single-shot | 30.1 | 0.0 | 74.9 | 30.0 | échoué | medium | $0.07 | 1.2 min |
| ||||||||
| 22 Arrow 2, Extra High Outil | 17.6 | 0.0 | 25.3 | 58.1 | échoué | — | ≥ $0.25 1 (borne inférieure : le coût réel est égal ou supérieur) | — 3 (non chronométré) |
| ||||||||
| — Gemini 3.1 Pro · max Partiel : 1 image sur 2 Agentique | 46.7 | 58.0 | 35.0 | 36.3 | passé | max | ≤ $1.6 2 (borne supérieure : le coût réel est égal ou inférieur) | 11 min |
| ||||||||
-
1 Claude Opus 5.5 · max Agentique 82.1 Score $51.9 Coût par image (USD)
- Fidélité
- 78.5
- Structure
- 92.1
- Détail
- 70.6
- Seuil de parité
- passé
- Effort
- max
- Piste
- Agentique
- Coût par image (USD)
- $51.9 (—)
- Durée par image
- 118 min (—)
- Exécutions
- 2
- Éditeur
- Anthropic
- Agent
- Claude Code 2.1.291
-
2 Claude Sonnet 5.5 · xhigh Agentique 79.5 Score $32.8 Coût par image (USD)
- Fidélité
- 76.0
- Structure
- 89.2
- Détail
- 68.8
- Seuil de parité
- passé
- Effort
- xhigh
- Piste
- Agentique
- Coût par image (USD)
- $32.8 ($20.5–$45.5)
- Durée par image
- 92 min (84 min–102 min)
- Exécutions
- 4
- Éditeur
- Anthropic
- Agent
- Claude Code 2.1.291
-
3 Claude Opus 5.5 · xhigh Agentique 78.4 Score $30.9 Coût par image (USD)
- Fidélité
- 72.6
- Structure
- 90.7
- Détail
- 68.8
- Seuil de parité
- passé
- Effort
- xhigh
- Piste
- Agentique
- Coût par image (USD)
- $30.9 ($20.8–$50.5)
- Durée par image
- 84 min (63 min–124 min)
- Exécutions
- 6
- Éditeur
- Anthropic
- Agent
- Claude Code 2.1.291
-
4 Claude Opus 5.5 · high Agentique 78.2 Score $22.9 Coût par image (USD)
- Fidélité
- 71.7
- Structure
- 91.8
- Détail
- 68.4
- Seuil de parité
- passé
- Effort
- high
- Piste
- Agentique
- Coût par image (USD)
- $22.9 ($13.3–$28.0)
- Durée par image
- 76 min (40 min–95 min)
- Exécutions
- 5
- Éditeur
- Anthropic
- Agent
- Claude Code 2.1.291
-
5 GPT 6.1 Sol · xhigh Agentique 73.9 Score $8.0 Coût par image (USD)
- Fidélité
- 64.0
- Structure
- 89.0
- Détail
- 73.1
- Seuil de parité
- passé
- Effort
- xhigh
- Piste
- Agentique
- Coût par image (USD)
- $8.0 ($6.0–$15.4)
- Durée par image
- 75 min (46 min–157 min)
- Exécutions
- 6
- Éditeur
- OpenAI
- Agent
- Codex CLI 0.160.0
-
6 GPT 6.1 Sol · high Agentique 73.3 Score $5.9 Coût par image (USD)
- Fidélité
- 60.8
- Structure
- 91.1
- Détail
- 73.1
- Seuil de parité
- mixte
- Effort
- high
- Piste
- Agentique
- Coût par image (USD)
- $5.9 (—)
- Durée par image
- 56 min (—)
- Exécutions
- 2
- Éditeur
- OpenAI
- Agent
- Codex CLI 0.160.0
-
7 Claude Sonnet 5.5 · high Agentique 72.7 Score $14.3 Coût par image (USD)
- Fidélité
- 65.2
- Structure
- 88.2
- Détail
- 61.3
- Seuil de parité
- passé
- Effort
- high
- Piste
- Agentique
- Coût par image (USD)
- $14.3 (—)
- Durée par image
- 53 min (—)
- Exécutions
- 2
- Éditeur
- Anthropic
- Agent
- Claude Code 2.1.291
-
8 † Claude Fable 5.1 · xhigh Agentique Essai A/B 72.6 Score $79.8 Coût par image (USD)
- Fidélité
- 66.4
- Structure
- 85.9
- Détail
- 61.9
- Seuil de parité
- mixte
- Effort
- xhigh
- Piste
- Agentique
- Coût par image (USD)
- $79.8 (—)
- Durée par image
- 92 min (—)
- Exécutions
- 2
- Éditeur
- Anthropic
- Agent
- Claude Code 2.1.291
- † Essai A/B
- Balade en vélo électrique : une exécution exploratoire de l’essai A/B, pas une exécution propre du protocole (exécutée avec une version antérieure du prompt, interrompue une fois puis reprise, travail délégué à des sous-agents et sur une version antérieure de l’agent). Elle est classée comme tout autre résultat ; une répétition selon le protocole est en attente.
-
9 Claude Opus 5.5 · medium Agentique 72.5 Score $13.1 Coût par image (USD)
- Fidélité
- 64.2
- Structure
- 88.3
- Détail
- 63.1
- Seuil de parité
- passé
- Effort
- medium
- Piste
- Agentique
- Coût par image (USD)
- $13.1 (—)
- Durée par image
- 62 min (—)
- Exécutions
- 2
- Éditeur
- Anthropic
- Agent
- Claude Code 2.1.291
-
10 GPT 6.1 Sol · medium Agentique 68.4 Score $5.2 Coût par image (USD)
- Fidélité
- 53.7
- Structure
- 88.5
- Détail
- 70.6
- Seuil de parité
- mixte
- Effort
- medium
- Piste
- Agentique
- Coût par image (USD)
- $5.2 (—)
- Durée par image
- 52 min (—)
- Exécutions
- 2
- Éditeur
- OpenAI
- Agent
- Codex CLI 0.160.0
-
11 GPT 6.1 Sol · xhigh Single-shot 48.8 Score $0.34 Coût par image (USD)
- Fidélité
- 15.1
- Structure
- 87.2
- Détail
- 67.5
- Seuil de parité
- échoué
- Effort
- xhigh
- Piste
- Single-shot
- Coût par image (USD)
- $0.34 ($0.29–$0.45)
- Durée par image
- 13 min (10 min–21 min)
- Exécutions
- 6
- Éditeur
- OpenAI
- Agent
- API call, no tools (Codex CLI 0.160.0)
-
12 Recraft Vectorize Outil 47.6 Score $0.01 Coût par image (USD)
- Fidélité
- 70.4
- Structure
- 6.3
- Détail
- 68.1
- Seuil de parité
- mixte
- Effort
- —
- Piste
- Outil
- Coût par image (USD)
- $0.01 (—)
- Durée par image
- — (non chronométré)
- Exécutions
- 2
- Éditeur
- Recraft
- Agent
- —
-
13 GPT 6.1 Sol · medium Single-shot 47.3 Score $0.17 Coût par image (USD)
- Fidélité
- 15.4
- Structure
- 86.9
- Détail
- 68.1
- Seuil de parité
- échoué
- Effort
- medium
- Piste
- Single-shot
- Coût par image (USD)
- $0.17 ($0.12–$0.24)
- Durée par image
- 5.4 min (3.7 min–7.5 min)
- Exécutions
- 10
- Éditeur
- OpenAI
- Agent
- API call, no tools (Codex CLI 0.160.0)
-
14 vtracer 0.6.15, default settings Outil 43.4 Score $0.00 Coût par image (USD)
- Fidélité
- 68.9
- Structure
- 2.5
- Détail
- 53.8
- Seuil de parité
- mixte
- Effort
- —
- Piste
- Outil
- Coût par image (USD)
- $0.00 (—)
- Durée par image
- 0.1 min (—)
- Exécutions
- 2
- Éditeur
- visioncortex (open source)
- Agent
- —
-
15 Claude Opus 5.5 · medium Boucle fixe 38.2 Score $1.8 Coût par image (USD)
- Fidélité
- 4.0
- Structure
- 84.4
- Détail
- 44.4
- Seuil de parité
- échoué
- Effort
- medium
- Piste
- Boucle fixe
- Coût par image (USD)
- $1.8 ($1.5–$2.4)
- Durée par image
- 11 min (7.2 min–15 min)
- Exécutions
- 4
- Éditeur
- Anthropic
- Agent
- API call, no tools (Claude Code 2.1.292)
-
16 Claude Fable 5.1 · medium Single-shot 37.4 Score $0.94 Coût par image (USD)
- Fidélité
- 3.1
- Structure
- 80.8
- Détail
- 48.8
- Seuil de parité
- échoué
- Effort
- medium
- Piste
- Single-shot
- Coût par image (USD)
- $0.94 ($0.67–$1.3)
- Durée par image
- 3.4 min (2.5 min–4.5 min)
- Exécutions
- 6
- Éditeur
- Anthropic
- Agent
- API call, no tools (Claude Code 2.1.292)
-
17 Claude Opus 5.5 · medium Single-shot 34.5 Score $0.33 Coût par image (USD)
- Fidélité
- 0.0
- Structure
- 80.0
- Détail
- 42.5
- Seuil de parité
- échoué
- Effort
- medium
- Piste
- Single-shot
- Coût par image (USD)
- $0.33 ($0.16–$0.42)
- Durée par image
- 2.8 min (1.7 min–3.5 min)
- Exécutions
- 6
- Éditeur
- Anthropic
- Agent
- API call, no tools (Claude Code 2.1.292)
-
18 Arrow 2 Telos, Extra High Outil 34.3 Score ≥ $0.35 1 Coût par image (USD) (borne inférieure : le coût réel est égal ou supérieur)
- Fidélité
- 9.3
- Structure
- 53.9
- Détail
- 71.9
- Seuil de parité
- échoué
- Effort
- —
- Piste
- Outil
- Coût par image (USD)
- ≥ $0.35 (—) (borne inférieure : le coût réel est égal ou supérieur)
- Durée par image
- — (non chronométré)
- Exécutions
- 2
- Éditeur
- Quiver AI
- Agent
- —
-
19 Claude Sonnet 5.5 · medium Boucle fixe 32.8 Score $0.38 Coût par image (USD)
- Fidélité
- 4.5
- Structure
- 74.8
- Détail
- 29.4
- Seuil de parité
- échoué
- Effort
- medium
- Piste
- Boucle fixe
- Coût par image (USD)
- $0.38 ($0.23–$0.59)
- Durée par image
- 3.7 min (1.8 min–6.2 min)
- Exécutions
- 4
- Éditeur
- Anthropic
- Agent
- API call, no tools (Claude Code 2.1.292)
-
20 Claude Haiku 5.5 · medium Single-shot 31.6 Score $0.01 Coût par image (USD)
- Fidélité
- 0.2
- Structure
- 77.0
- Détail
- 30.6
- Seuil de parité
- échoué
- Effort
- medium
- Piste
- Single-shot
- Coût par image (USD)
- $0.01 ($0.00–$0.01)
- Durée par image
- 1 min (0.5 min–1.4 min)
- Exécutions
- 6
- Éditeur
- Anthropic
- Agent
- API call, no tools (Claude Code 2.1.294)
-
21 Claude Sonnet 5.5 · medium Single-shot 30.1 Score $0.07 Coût par image (USD)
- Fidélité
- 0.0
- Structure
- 74.9
- Détail
- 30.0
- Seuil de parité
- échoué
- Effort
- medium
- Piste
- Single-shot
- Coût par image (USD)
- $0.07 ($0.04–$0.15)
- Durée par image
- 1.2 min (0.5 min–2.1 min)
- Exécutions
- 6
- Éditeur
- Anthropic
- Agent
- API call, no tools (Claude Code 2.1.292)
-
22 Arrow 2, Extra High Outil 17.6 Score ≥ $0.25 1 Coût par image (USD) (borne inférieure : le coût réel est égal ou supérieur)
- Fidélité
- 0.0
- Structure
- 25.3
- Détail
- 58.1
- Seuil de parité
- échoué
- Effort
- —
- Piste
- Outil
- Coût par image (USD)
- ≥ $0.25 (—) (borne inférieure : le coût réel est égal ou supérieur)
- Durée par image
- — (non chronométré)
- Exécutions
- 2
- Éditeur
- Quiver AI
- Agent
- —
-
— Gemini 3.1 Pro · max Agentique Partiel : 1 image sur 2 46.7 Score ≤ $1.6 2 Coût par image (USD) (borne supérieure : le coût réel est égal ou inférieur)
- Fidélité
- 58.0
- Structure
- 35.0
- Détail
- 36.3
- Seuil de parité
- passé
- Effort
- max
- Piste
- Agentique
- Coût par image (USD)
- ≤ $1.6 (—) (borne supérieure : le coût réel est égal ou inférieur)
- Durée par image
- 11 min (—)
- Exécutions
- 1
- Éditeur
- Agent
- Gemini CLI 0.62.0
† Claude Fable 5.1 · xhigh (Essai A/B): Balade en vélo électrique : une exécution exploratoire de l’essai A/B, pas une exécution propre du protocole (exécutée avec une version antérieure du prompt, interrompue une fois puis reprise, travail délégué à des sous-agents et sur une version antérieure de l’agent). Elle est classée comme tout autre résultat ; une répétition selon le protocole est en attente. 1 borne inférieure : le coût réel est égal ou supérieur 2 borne supérieure : le coût réel est égal ou inférieur 3 non chronométré
Score contre coût
Chaque participant, placé selon son Samsa Vectorization Score et le coût d'une image. En haut à gauche, c'est mieux ; la ligne relie les participants que personne ne bat sur les deux axes.
- Piste
- Score
- Fidélité
- Structure
- Détail
- Coût par image (USD)
- Durée par image
- Seuil de parité
- Anthropic
- OpenAI
- Agentique
- Single-shot
- Boucle fixe
- Outils
- Frontière de Pareto
- Coût : borne inférieure
- Coût : borne supérieure
† Claude Fable 5.1 · xhigh (Essai A/B): Balade en vélo électrique : une exécution exploratoire de l’essai A/B, pas une exécution propre du protocole (exécutée avec une version antérieure du prompt, interrompue une fois puis reprise, travail délégué à des sous-agents et sur une version antérieure de l’agent). Elle est classée comme tout autre résultat ; une répétition selon le protocole est en attente.
Classement ↑Absents du graphique : Recraft Vectorize, Arrow 2 Telos, Extra High et Arrow 2, Extra High. Leur durée n'a pas été mesurée.
Résultats
L'original, puis chaque rendu dans l'ordre du classement. Ouvre une carte pour la comparer à l'original et inspecter les zooms.
Résultats : Balade en vélo électrique
-
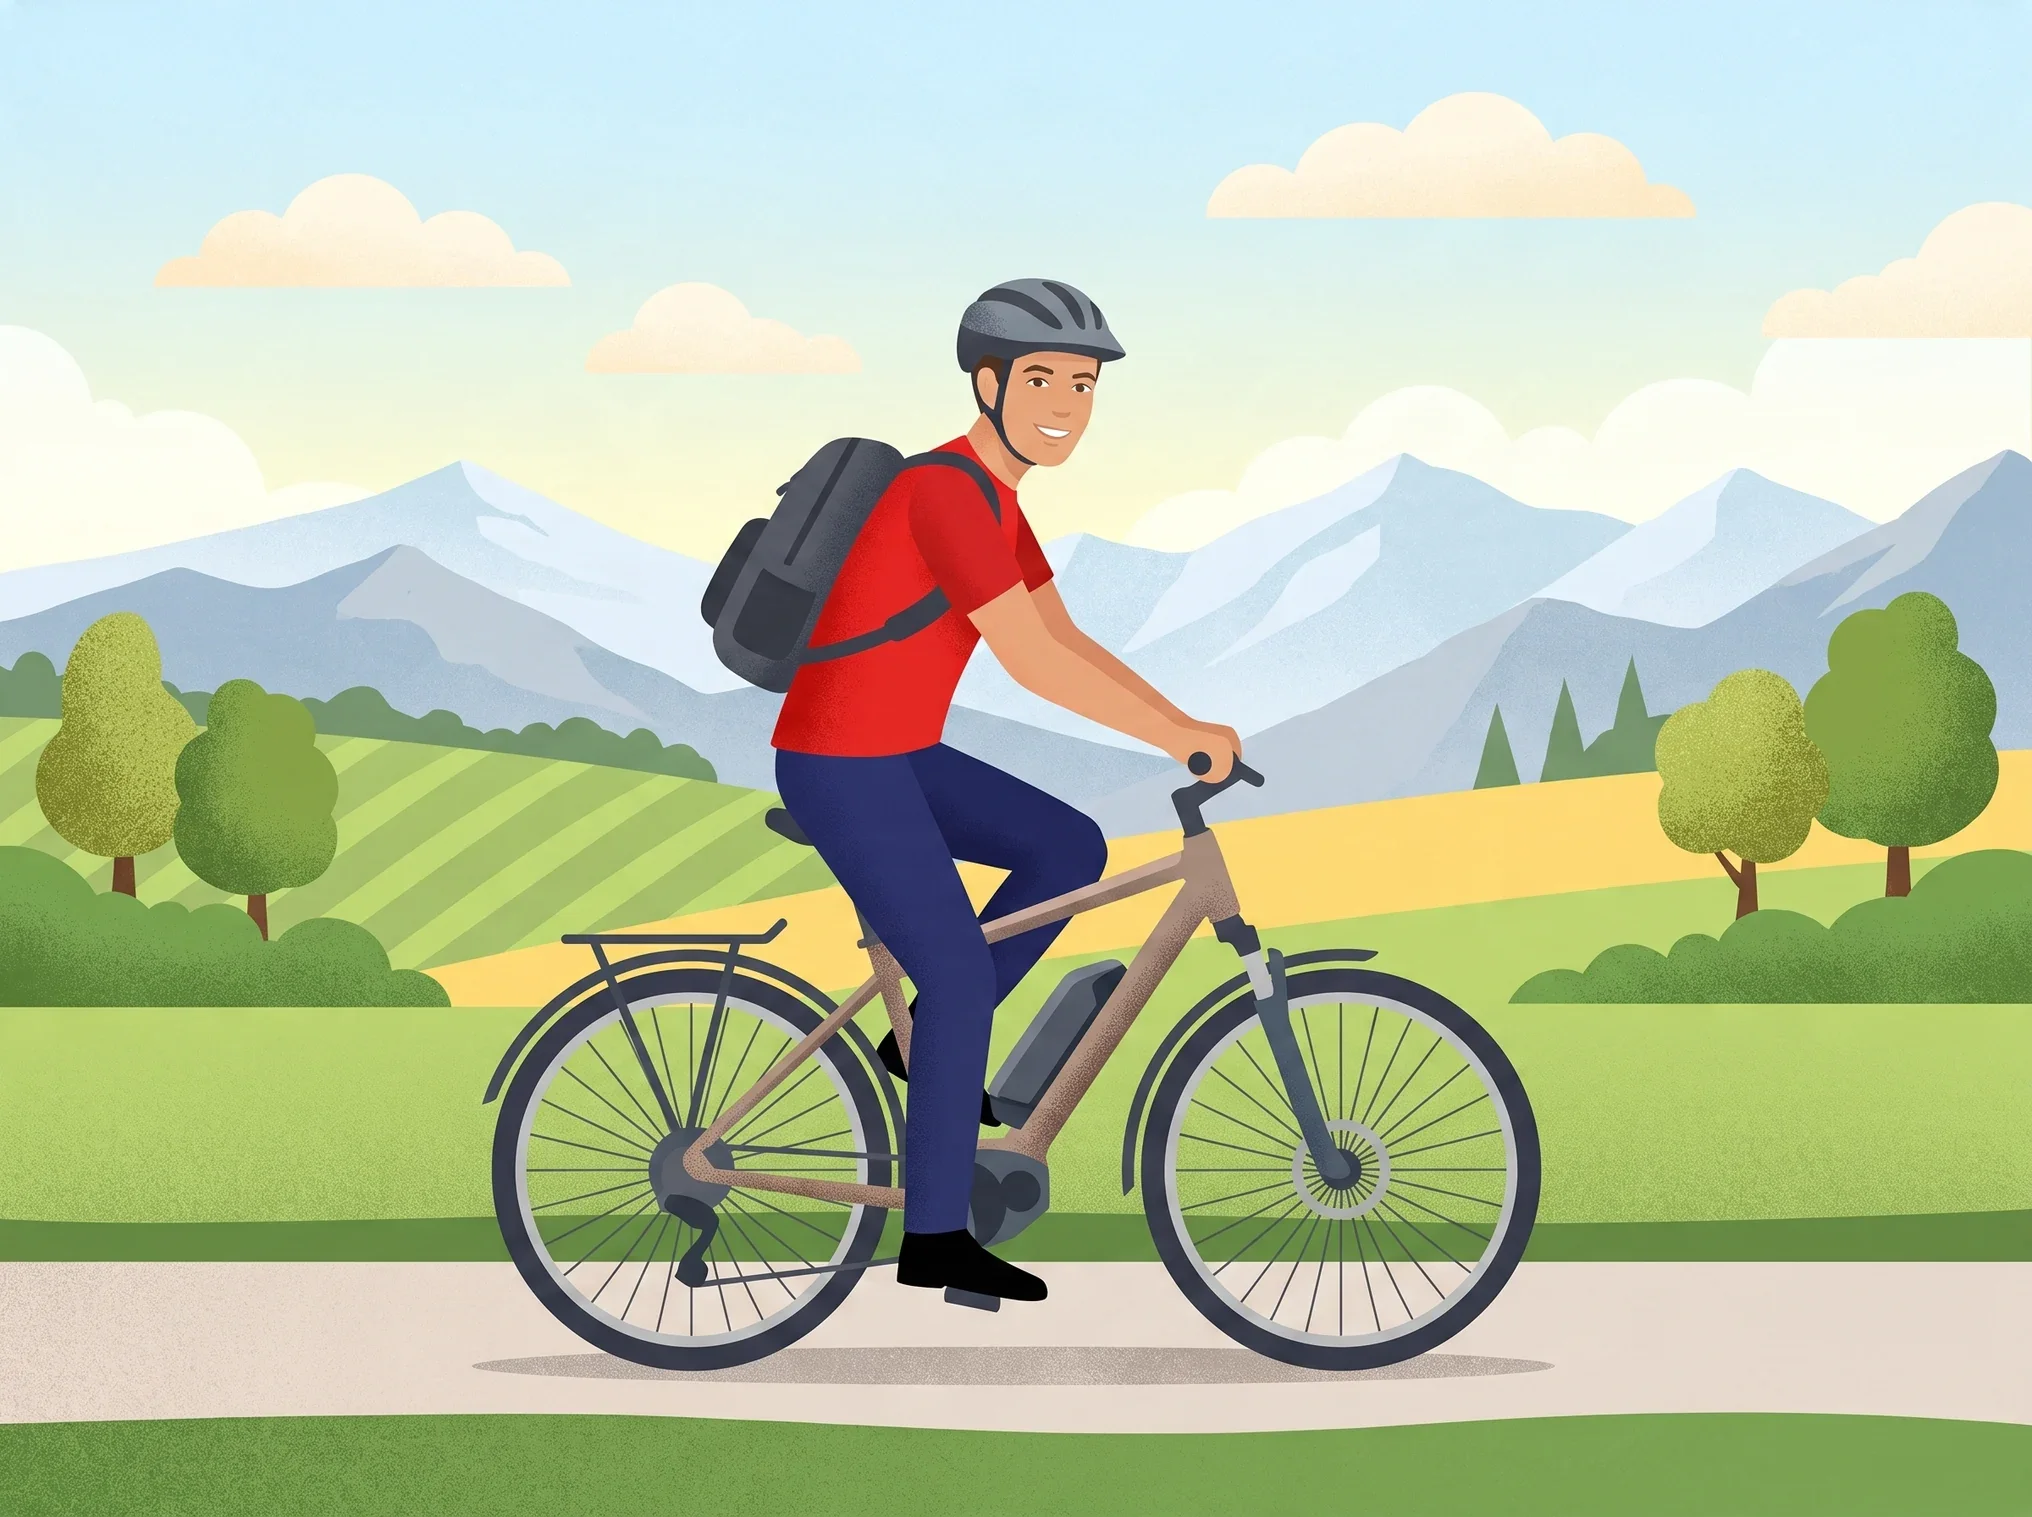
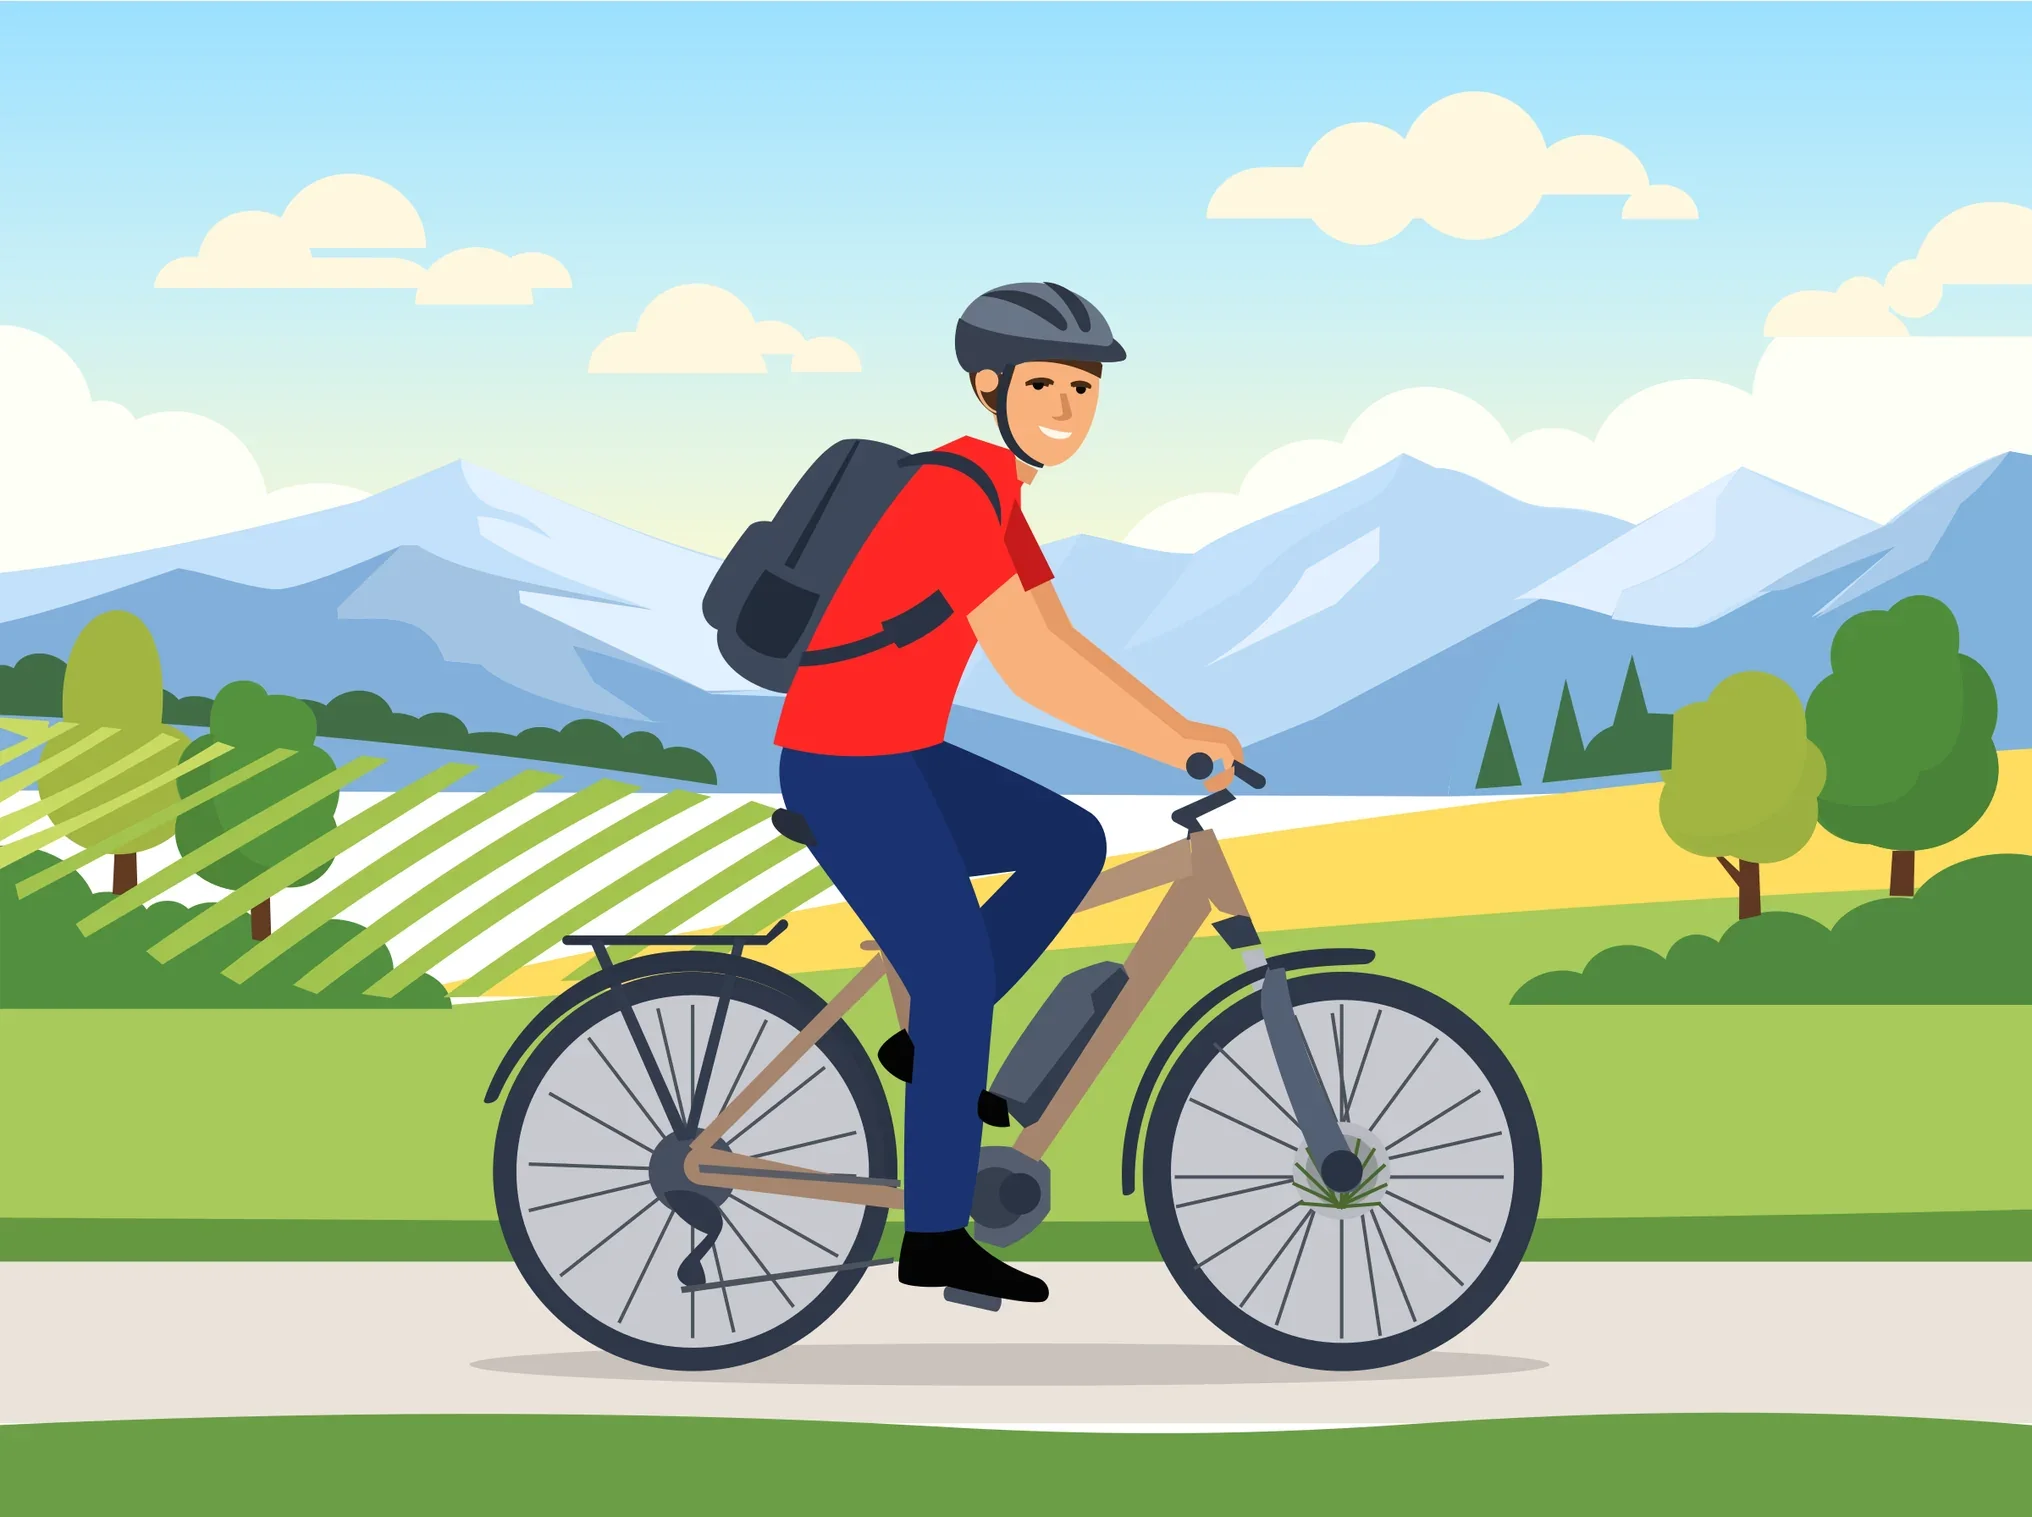
Original
2400 × 1792 px
-
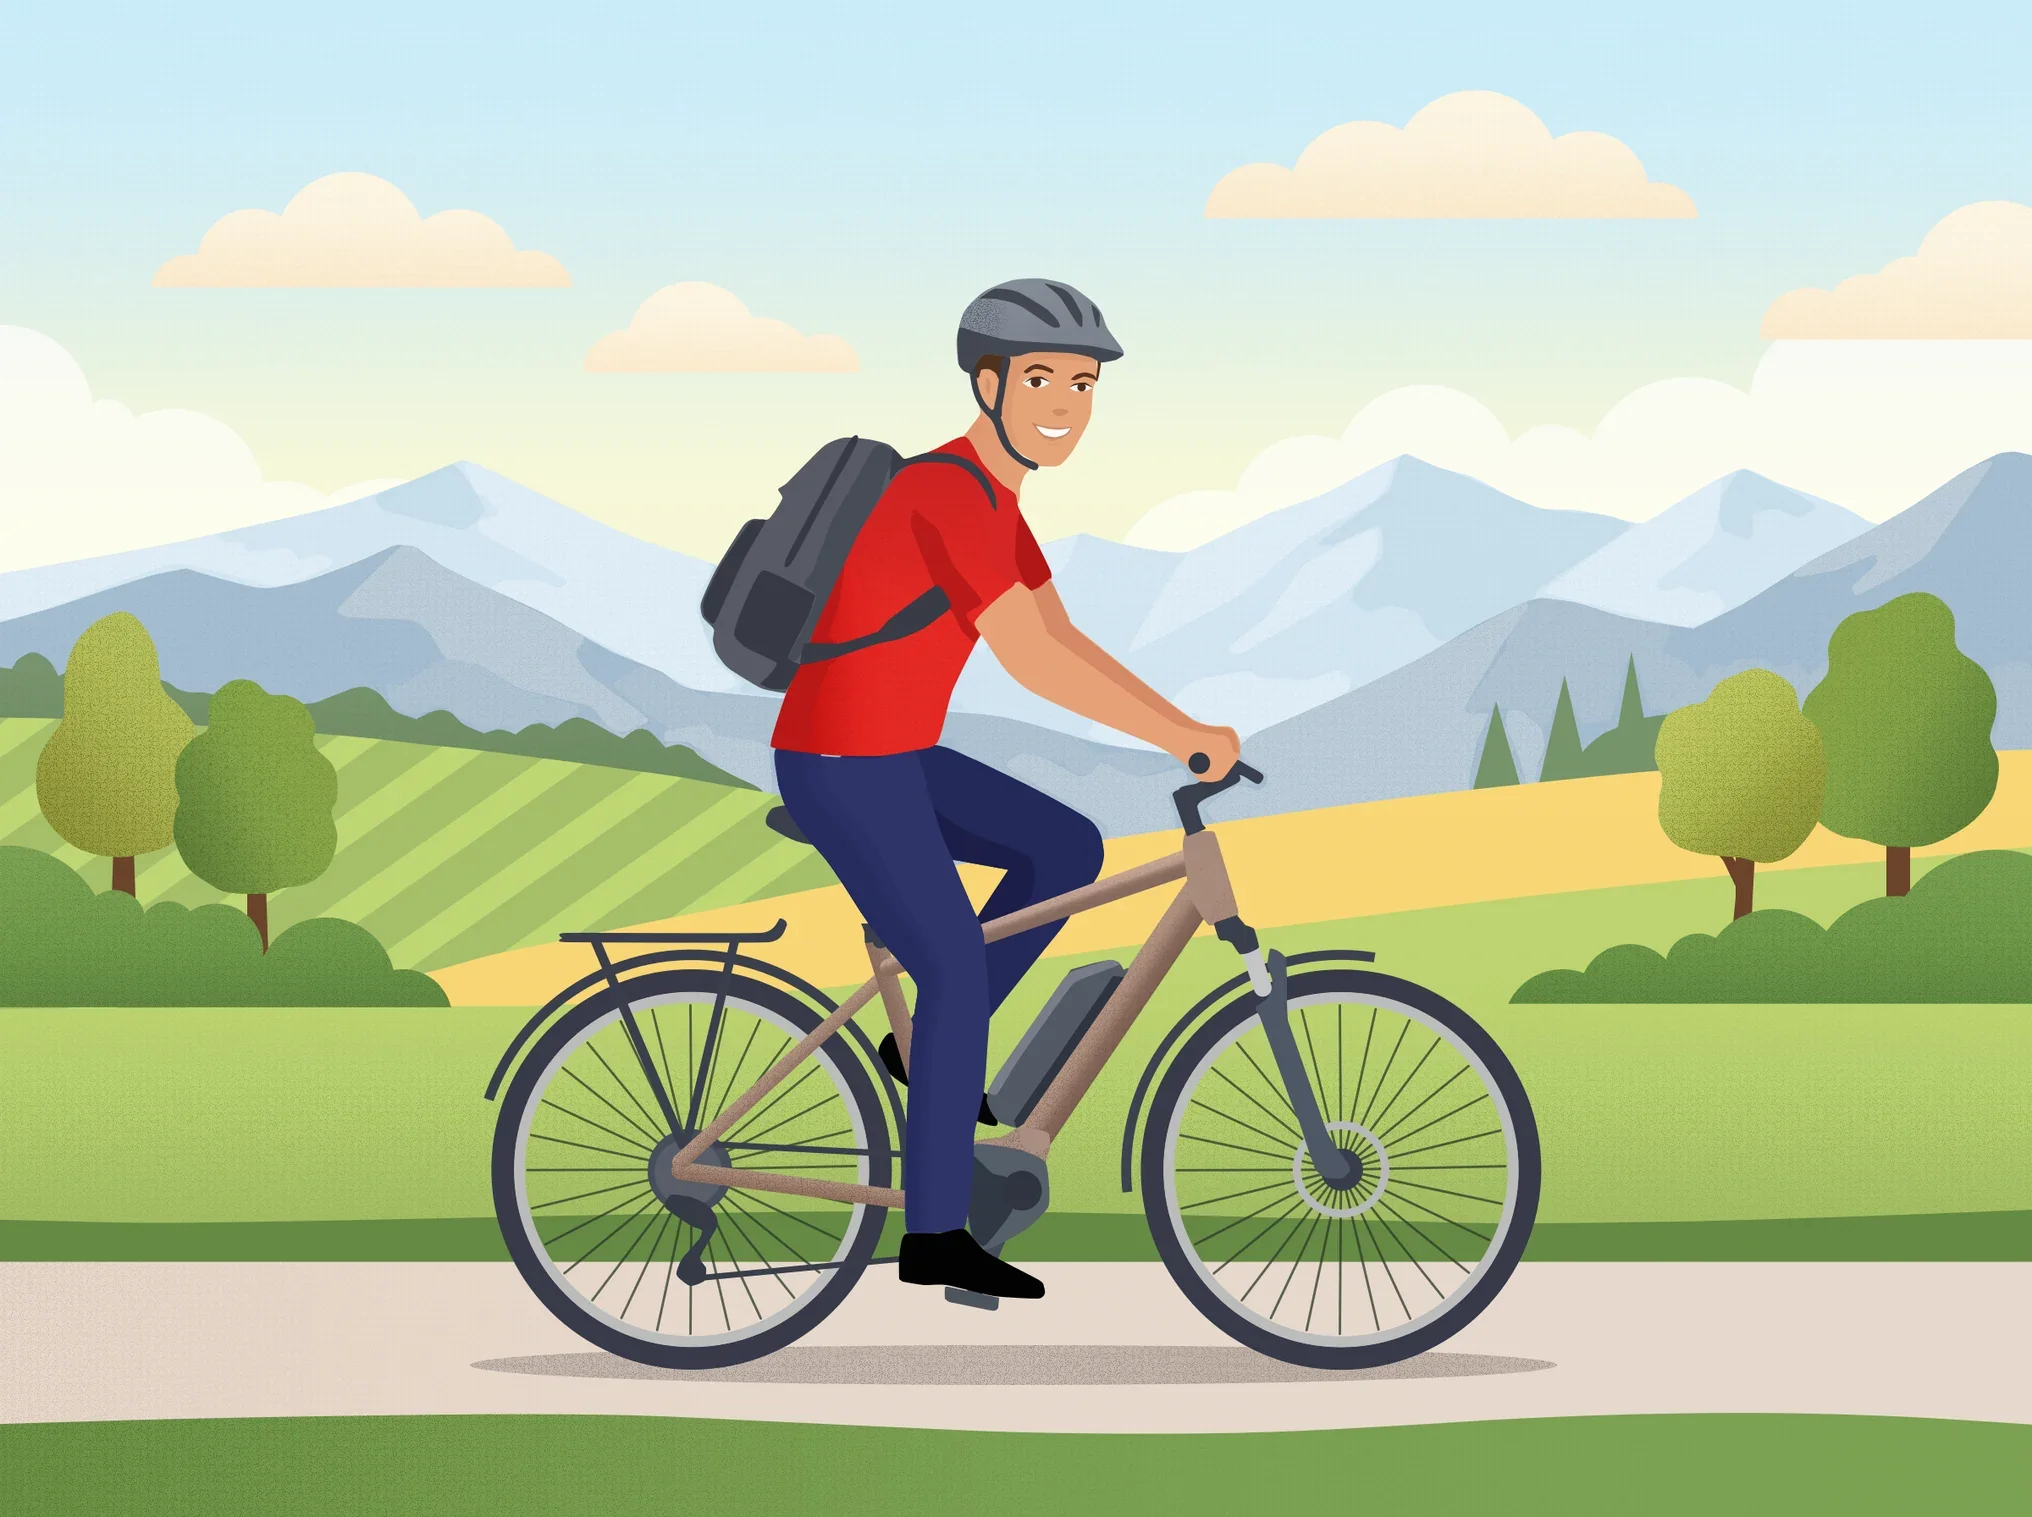
#1 Claude Opus 5.5 · max
76.7 Score $60.3 128 min passé Agentique
-
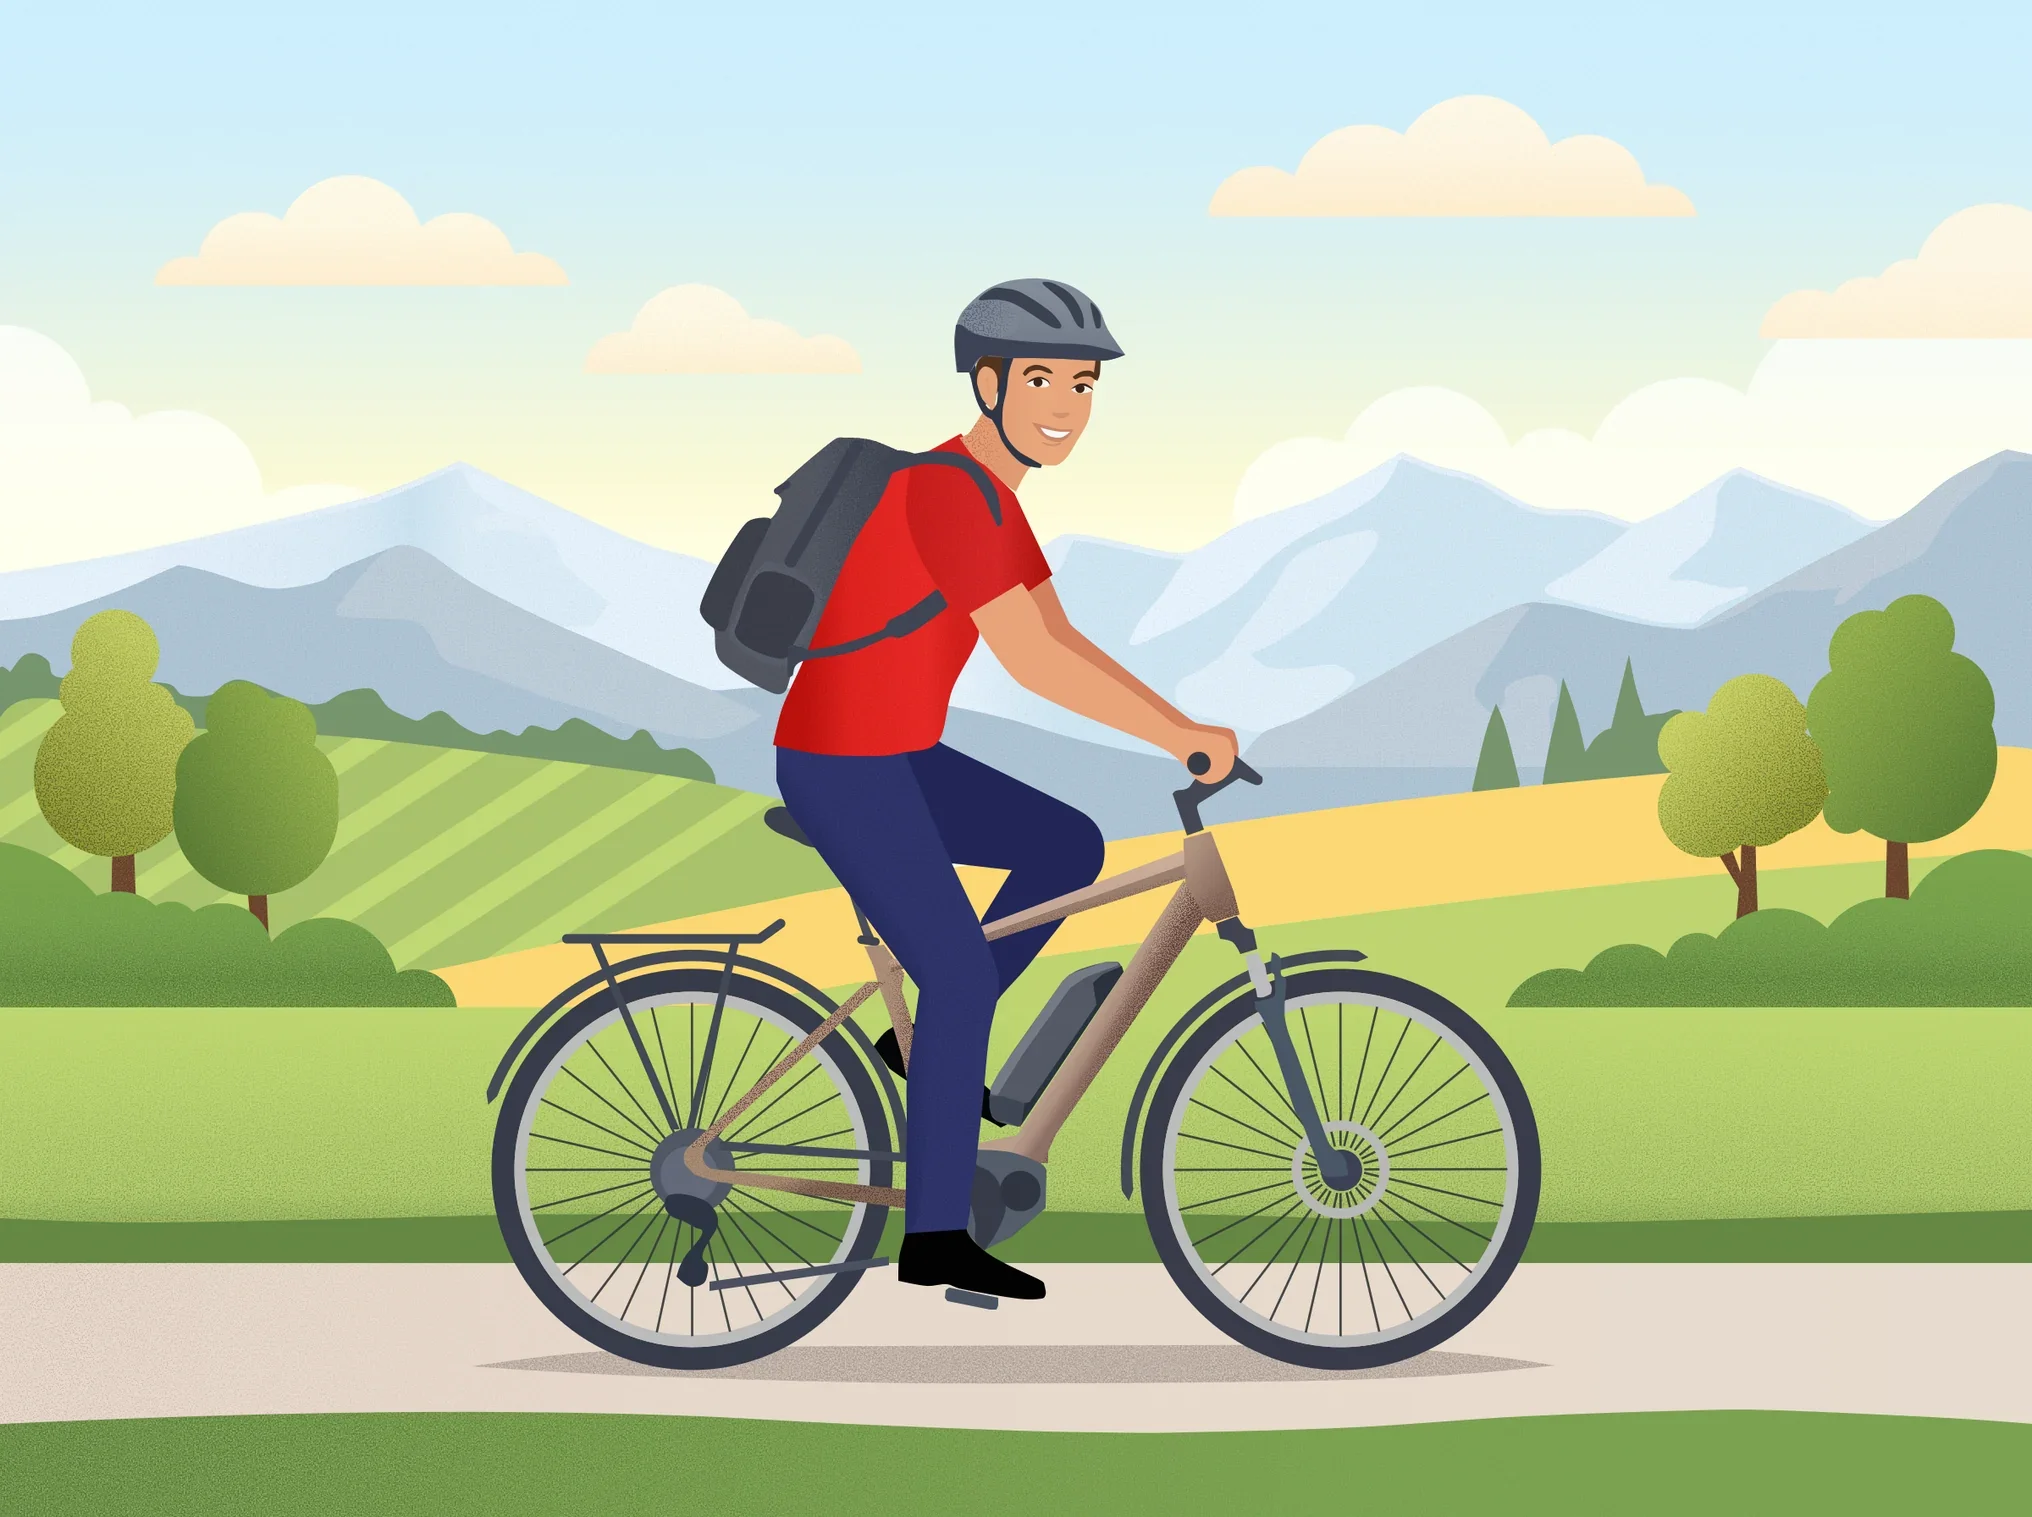
#2 Claude Sonnet 5.5 · xhigh
74.8 Score $42.2 100 min passé Agentique
-
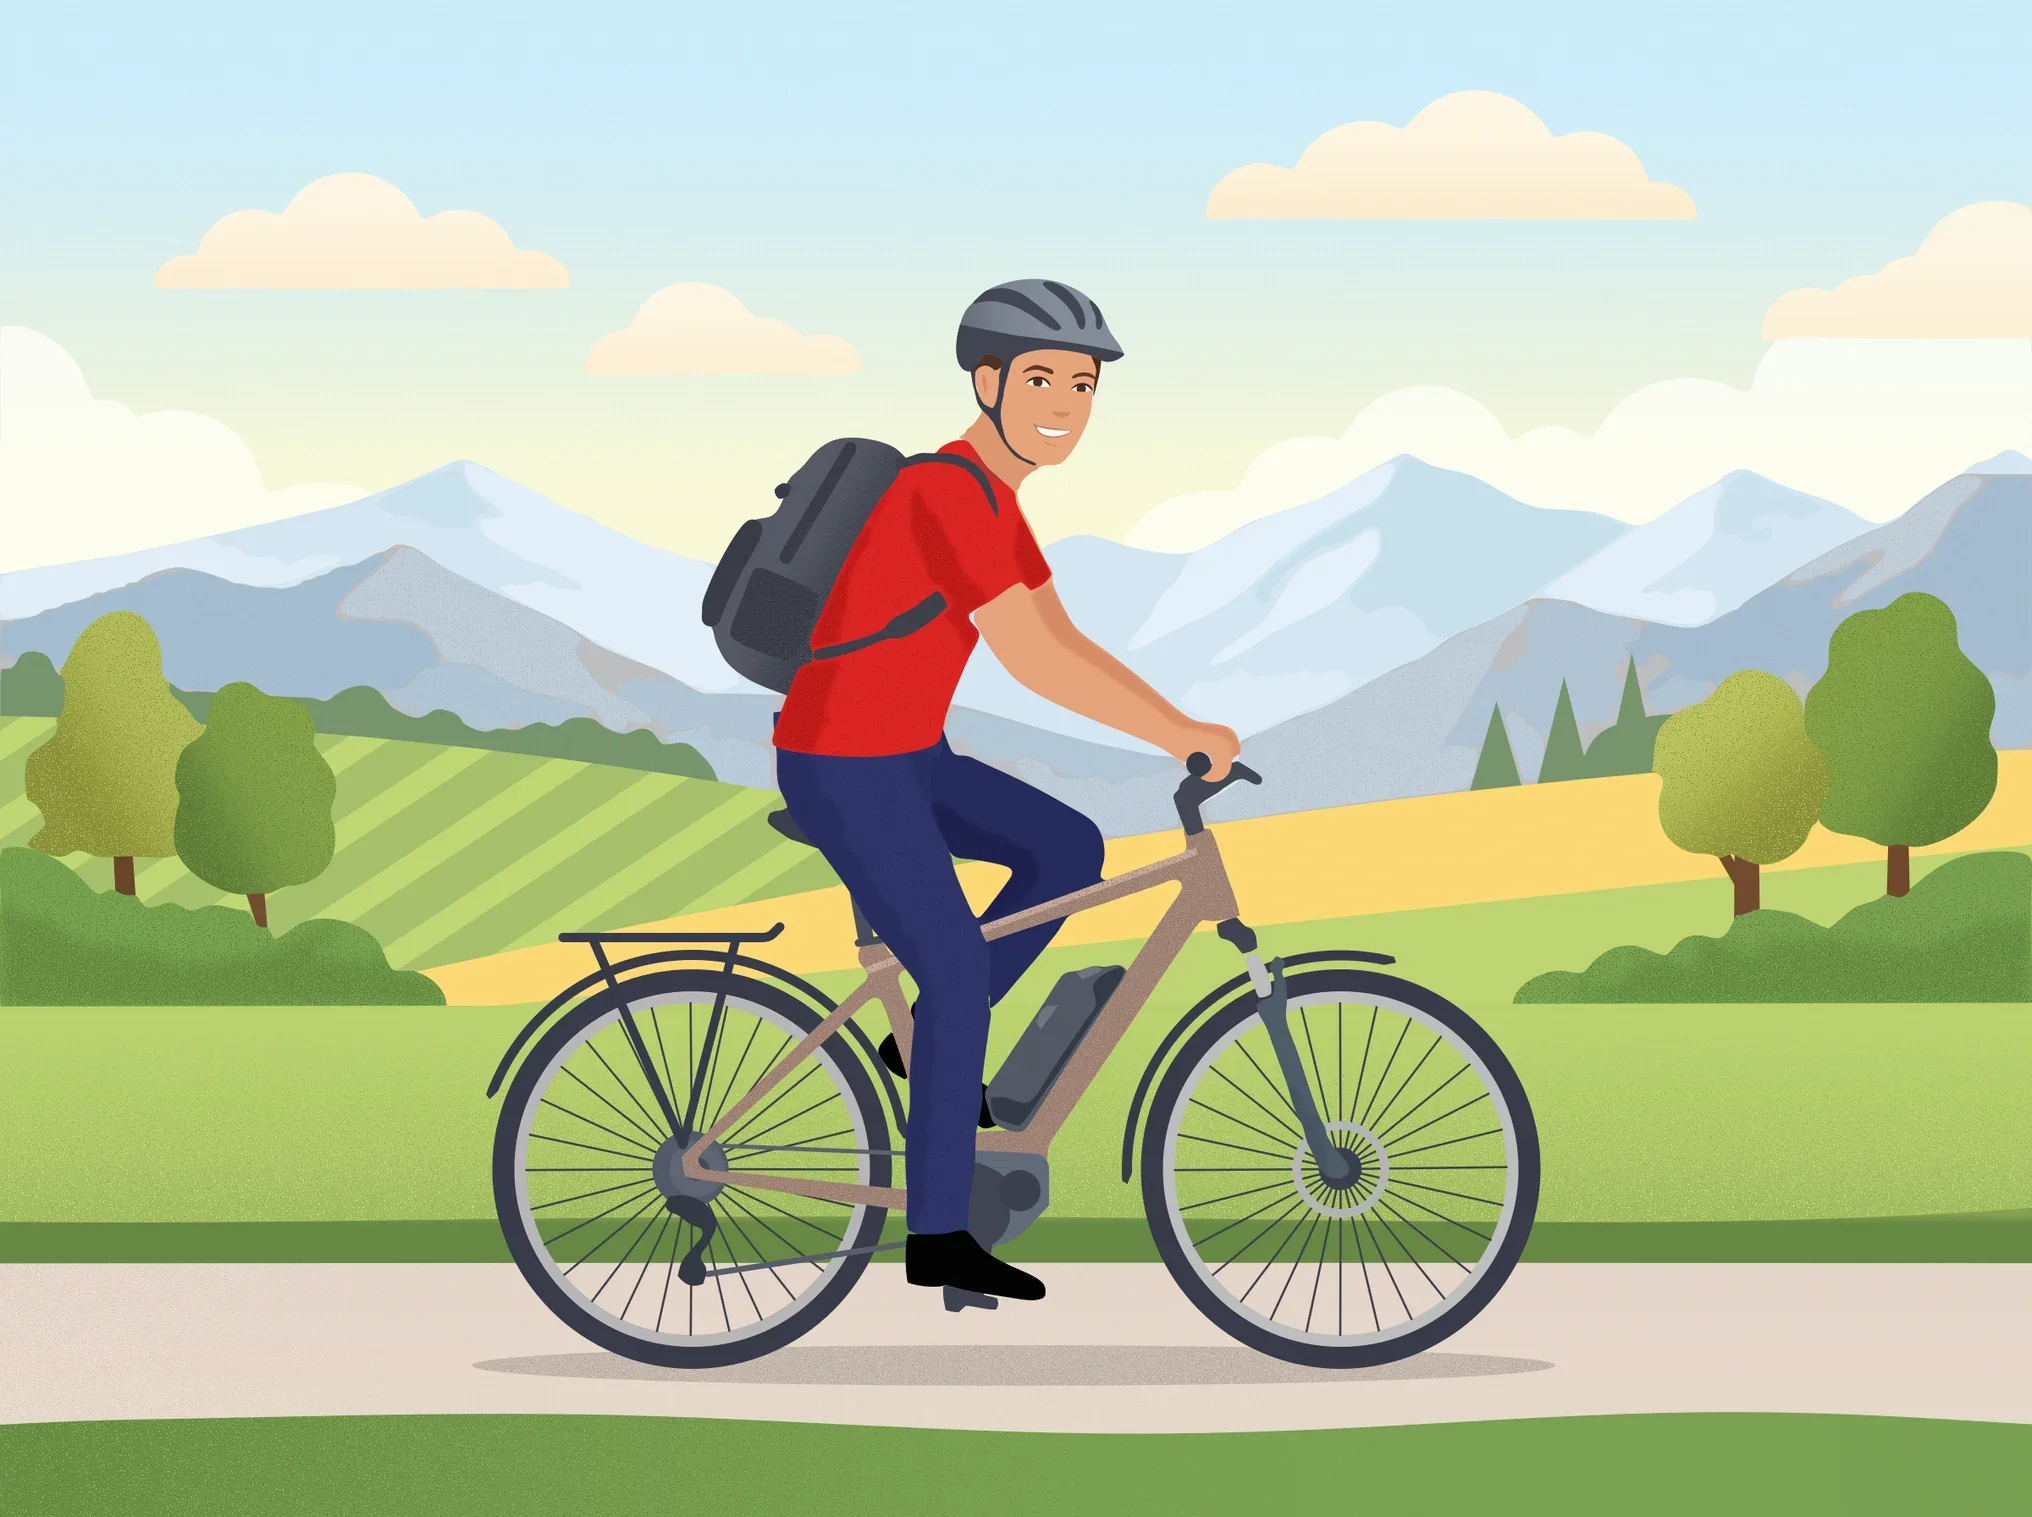
#3 Claude Opus 5.5 · xhigh
73.1 Score $34.7 85 min passé Agentique
-
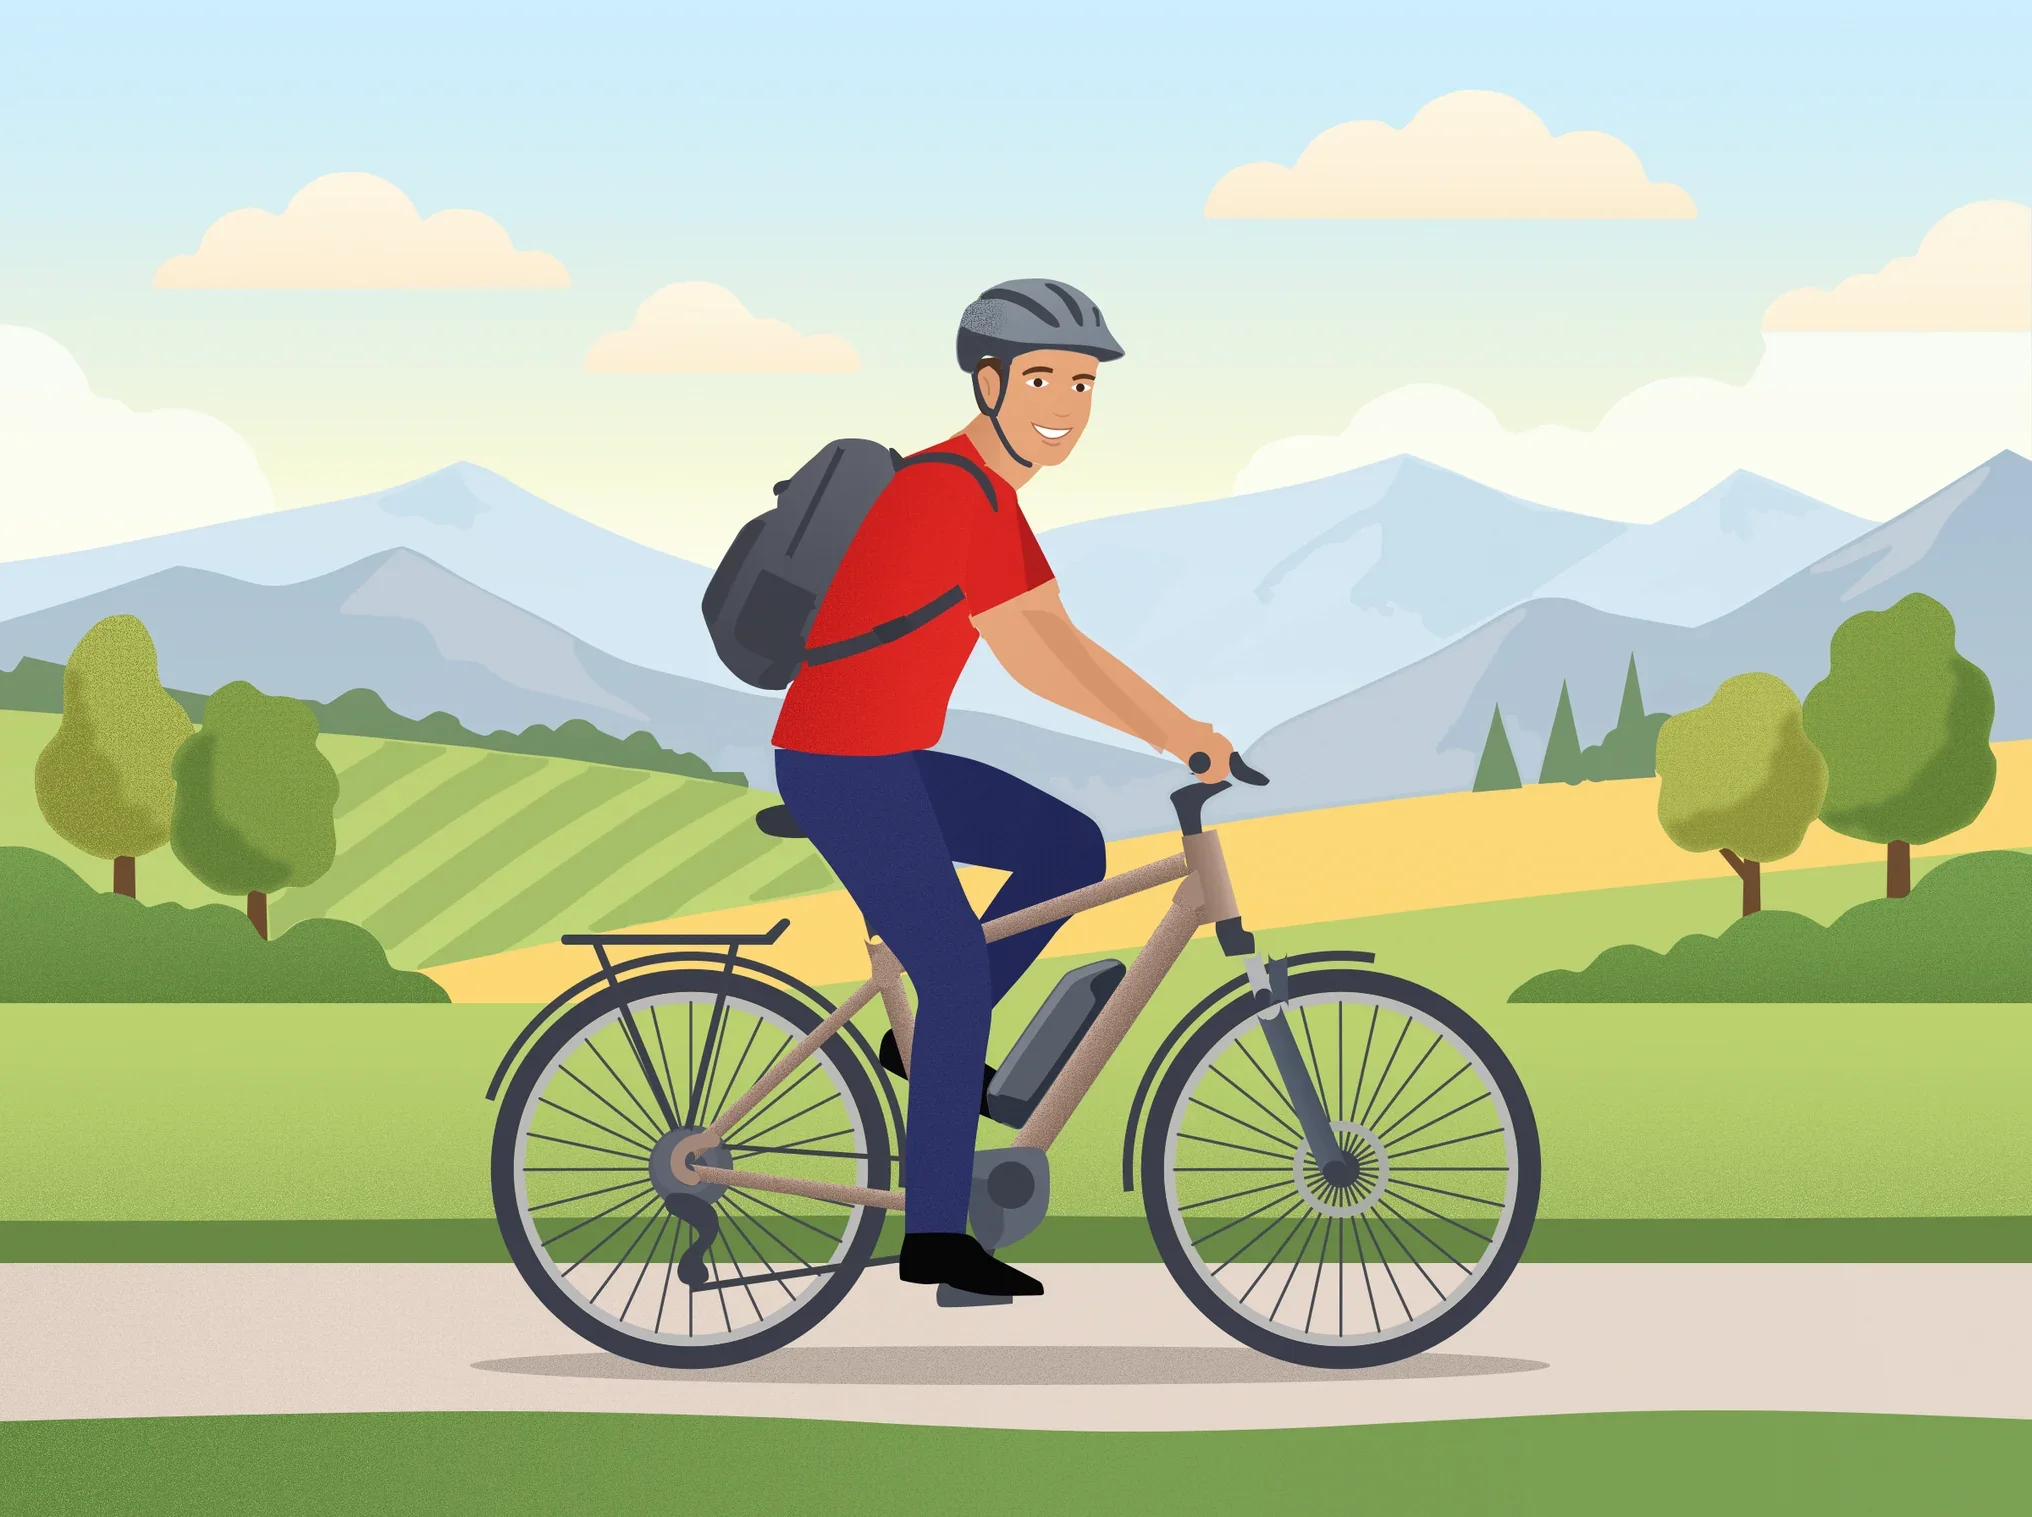
#4 Claude Opus 5.5 · high
71.7 Score $26.2 80 min passé Agentique
-
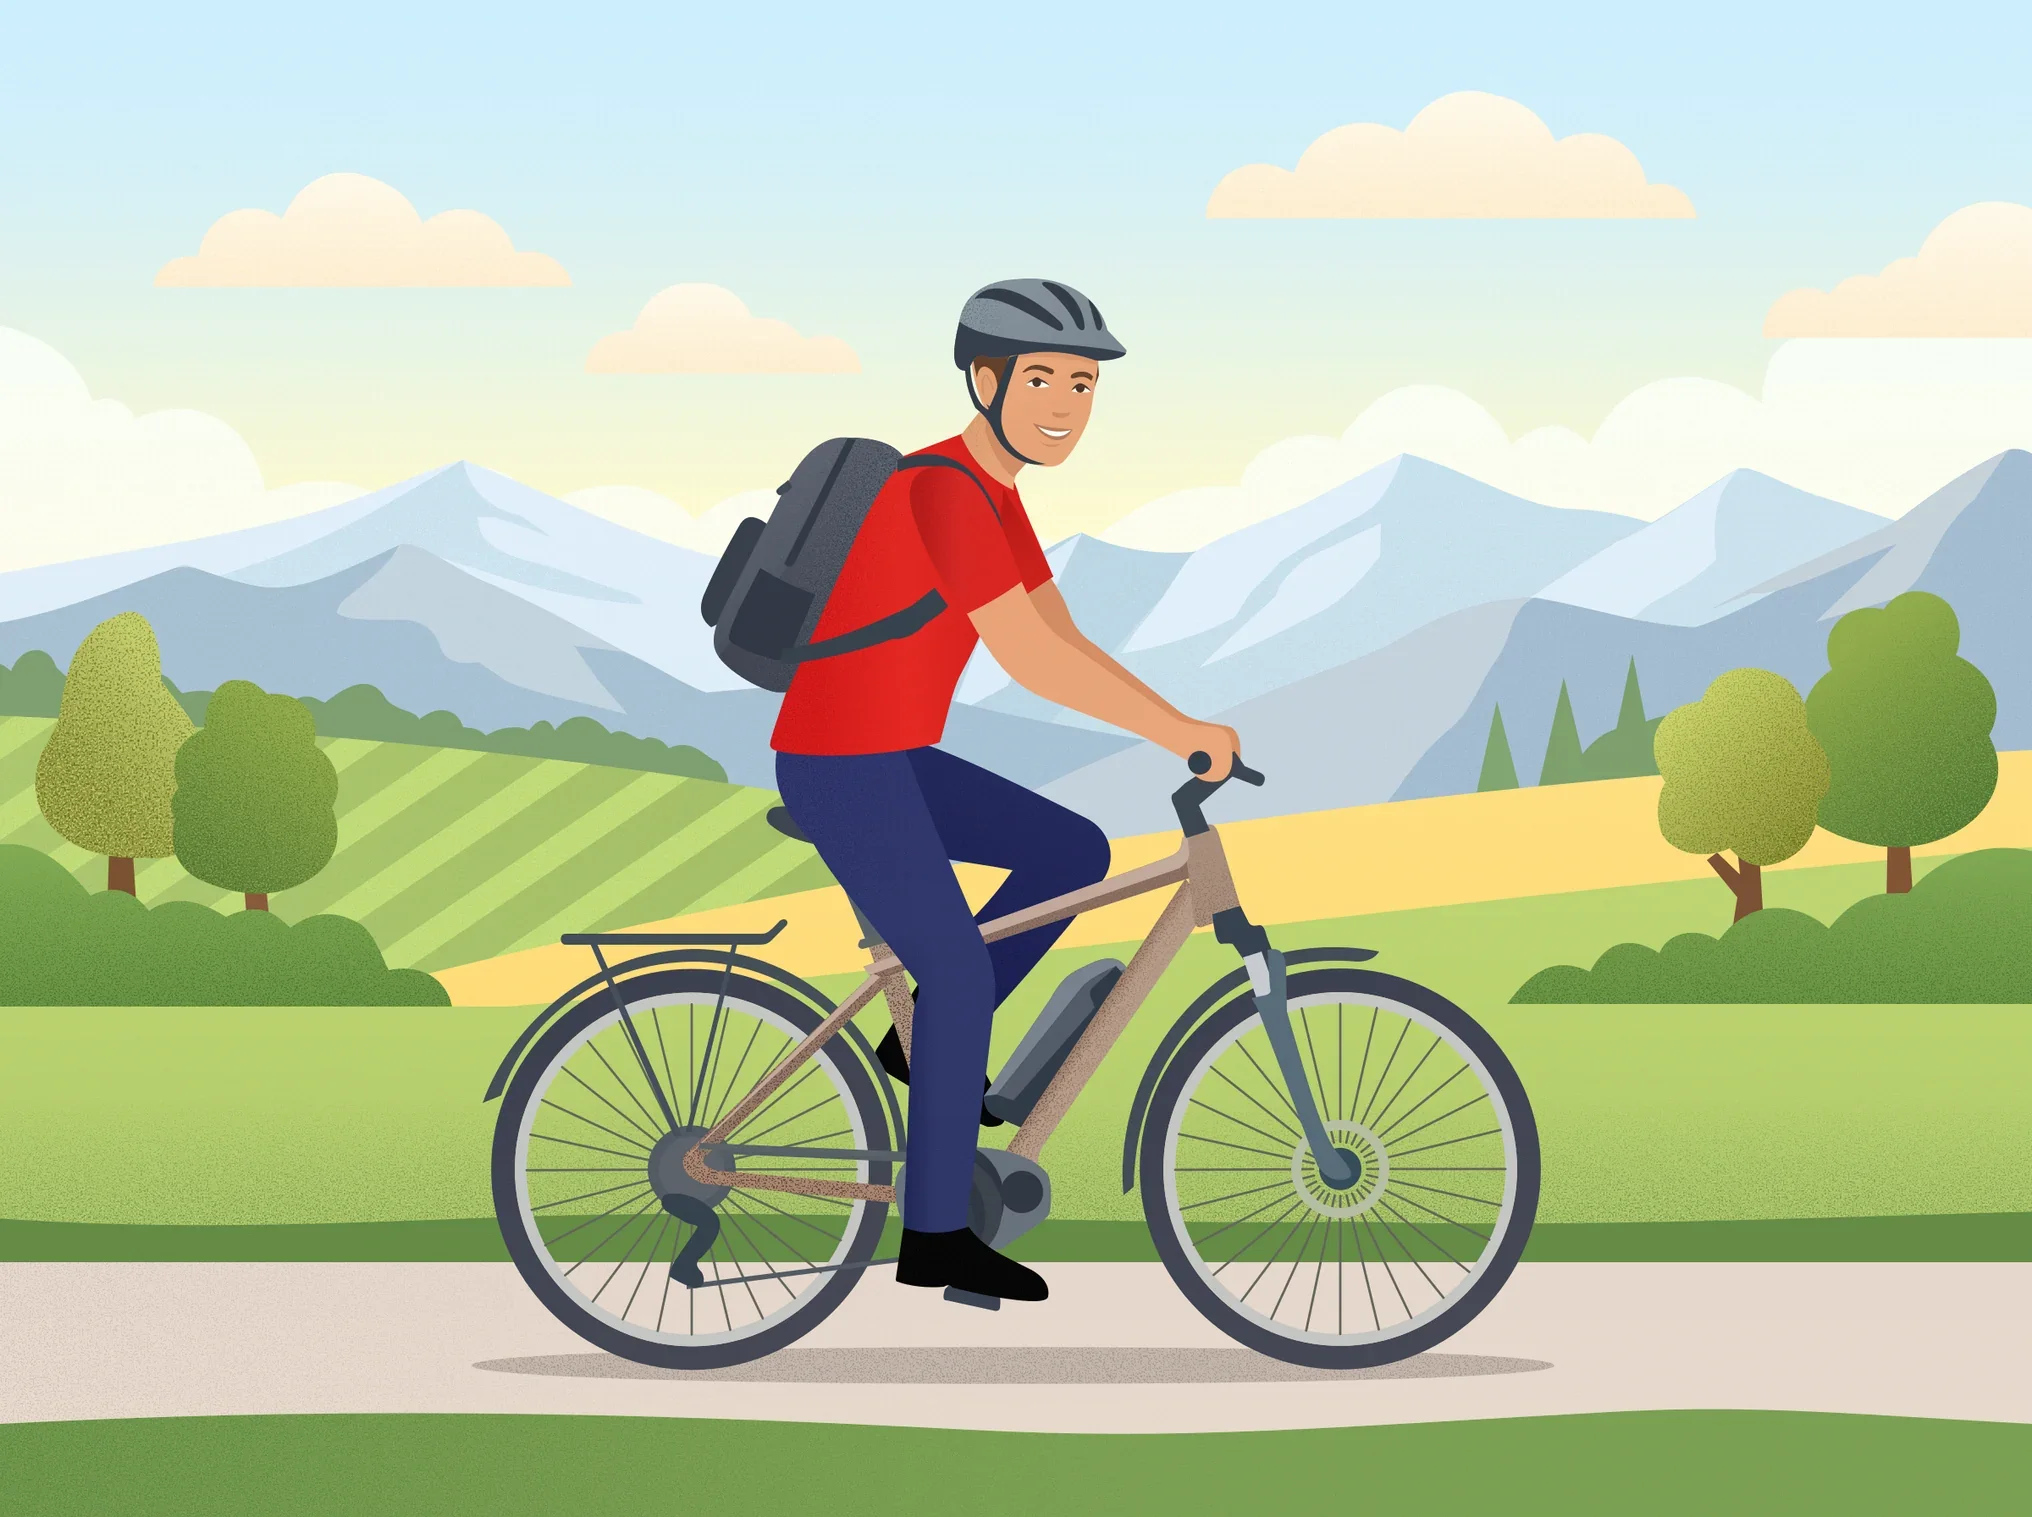
#5 GPT 6.1 Sol · xhigh
72.2 Score $9.1 93 min passé Agentique
-
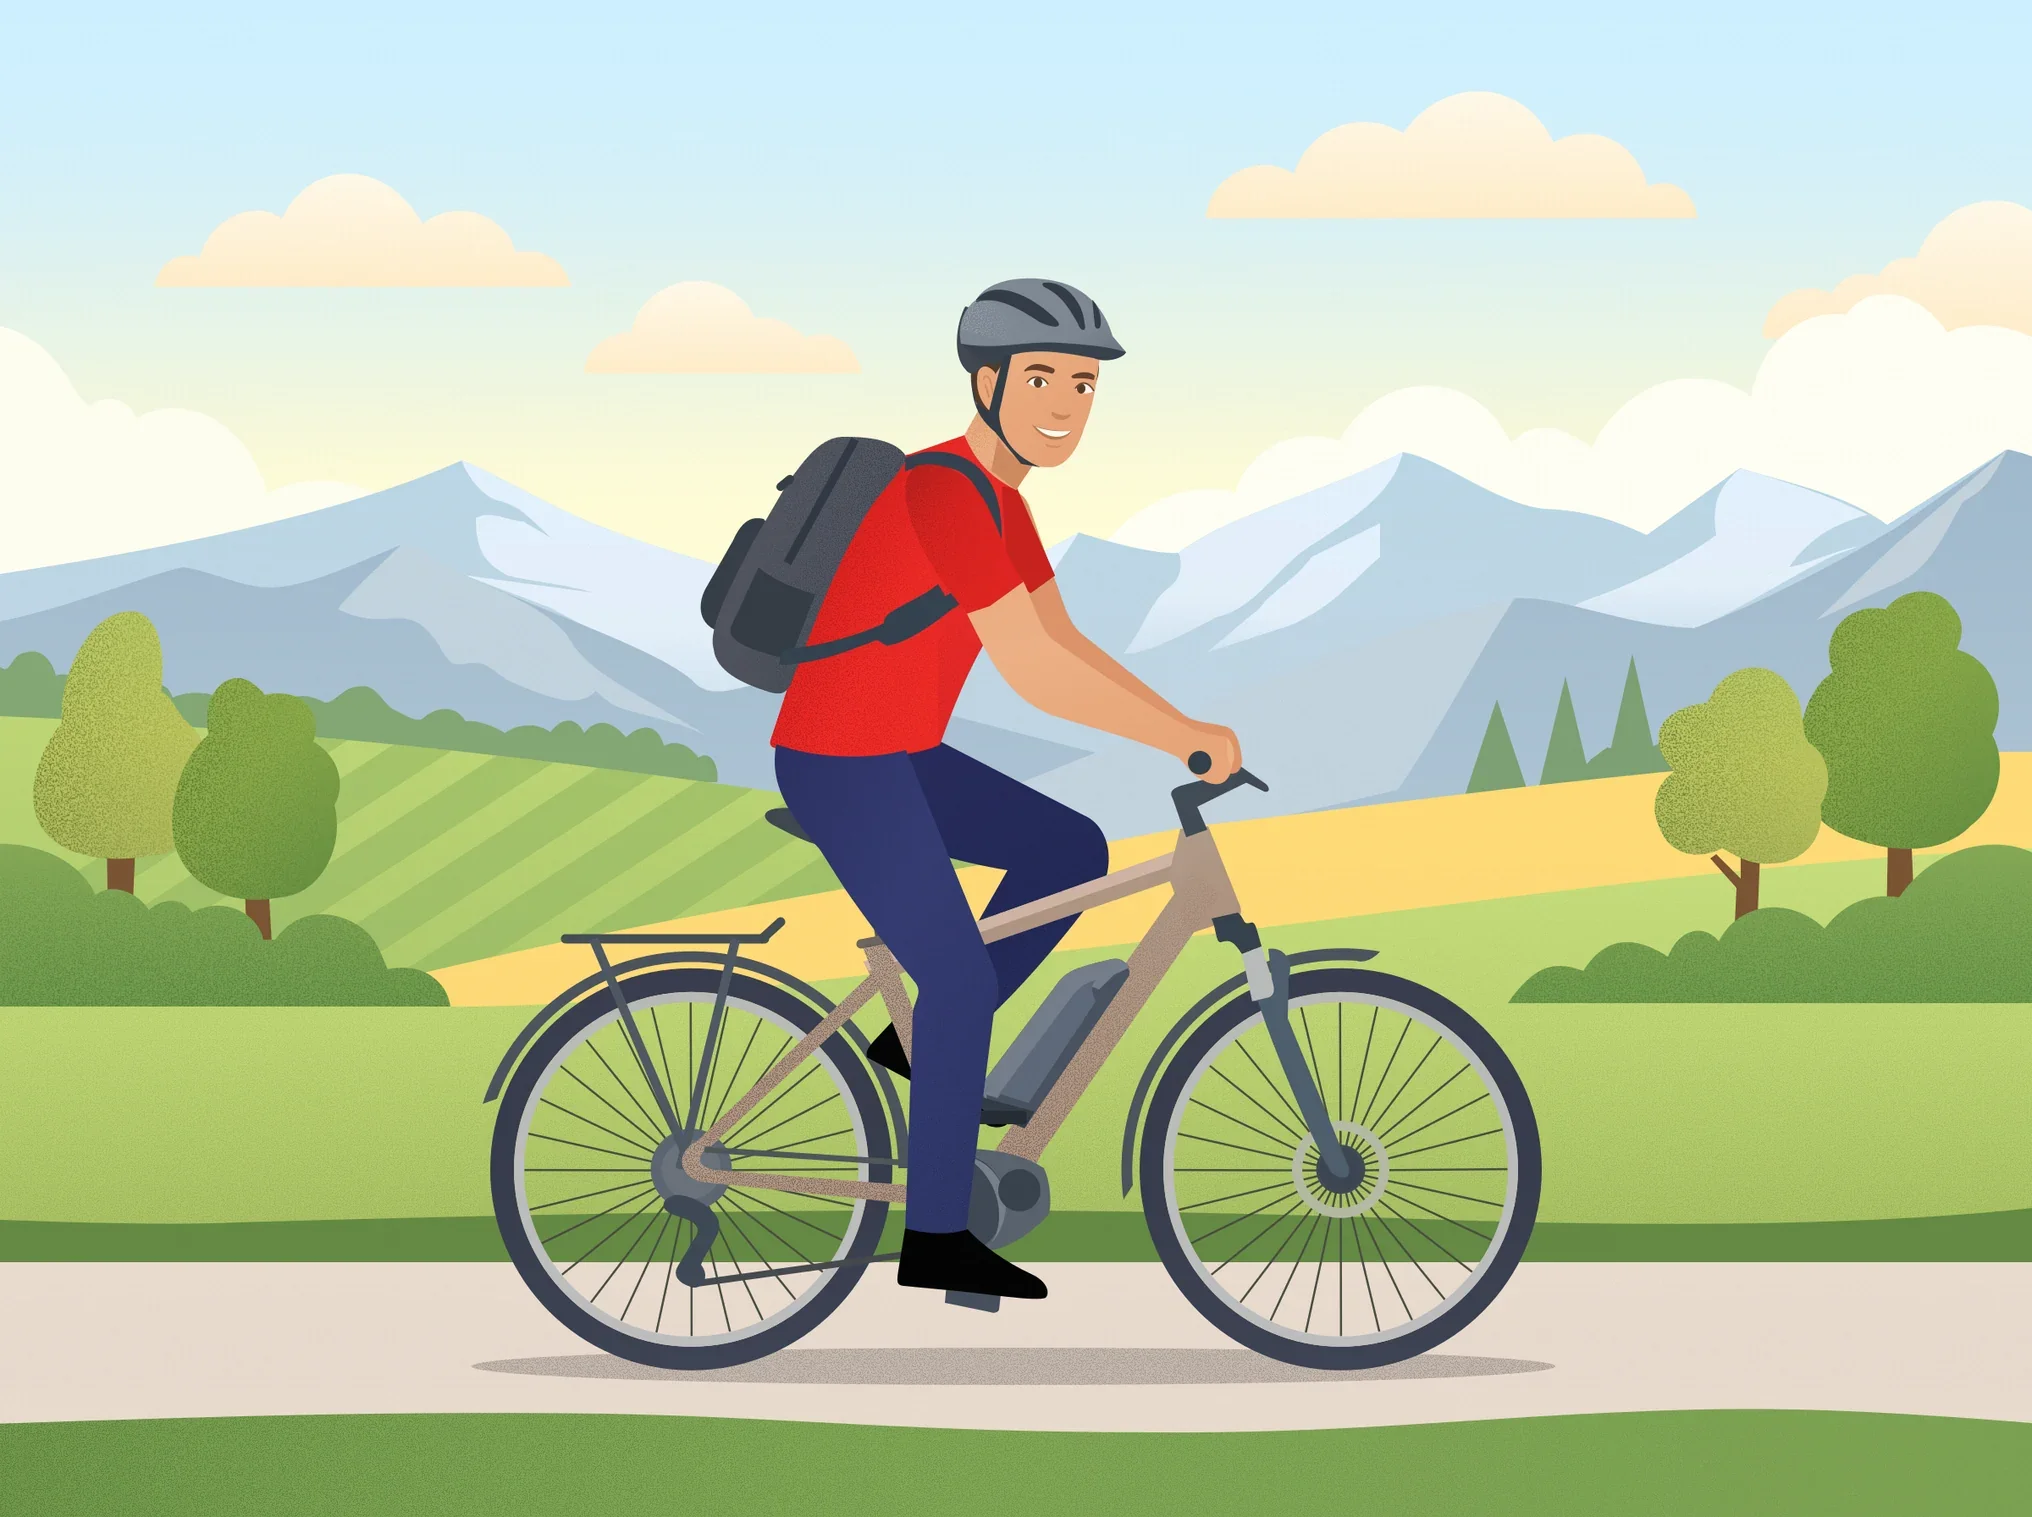
#6 GPT 6.1 Sol · high
72.1 Score $6.4 65 min échoué Agentique
-
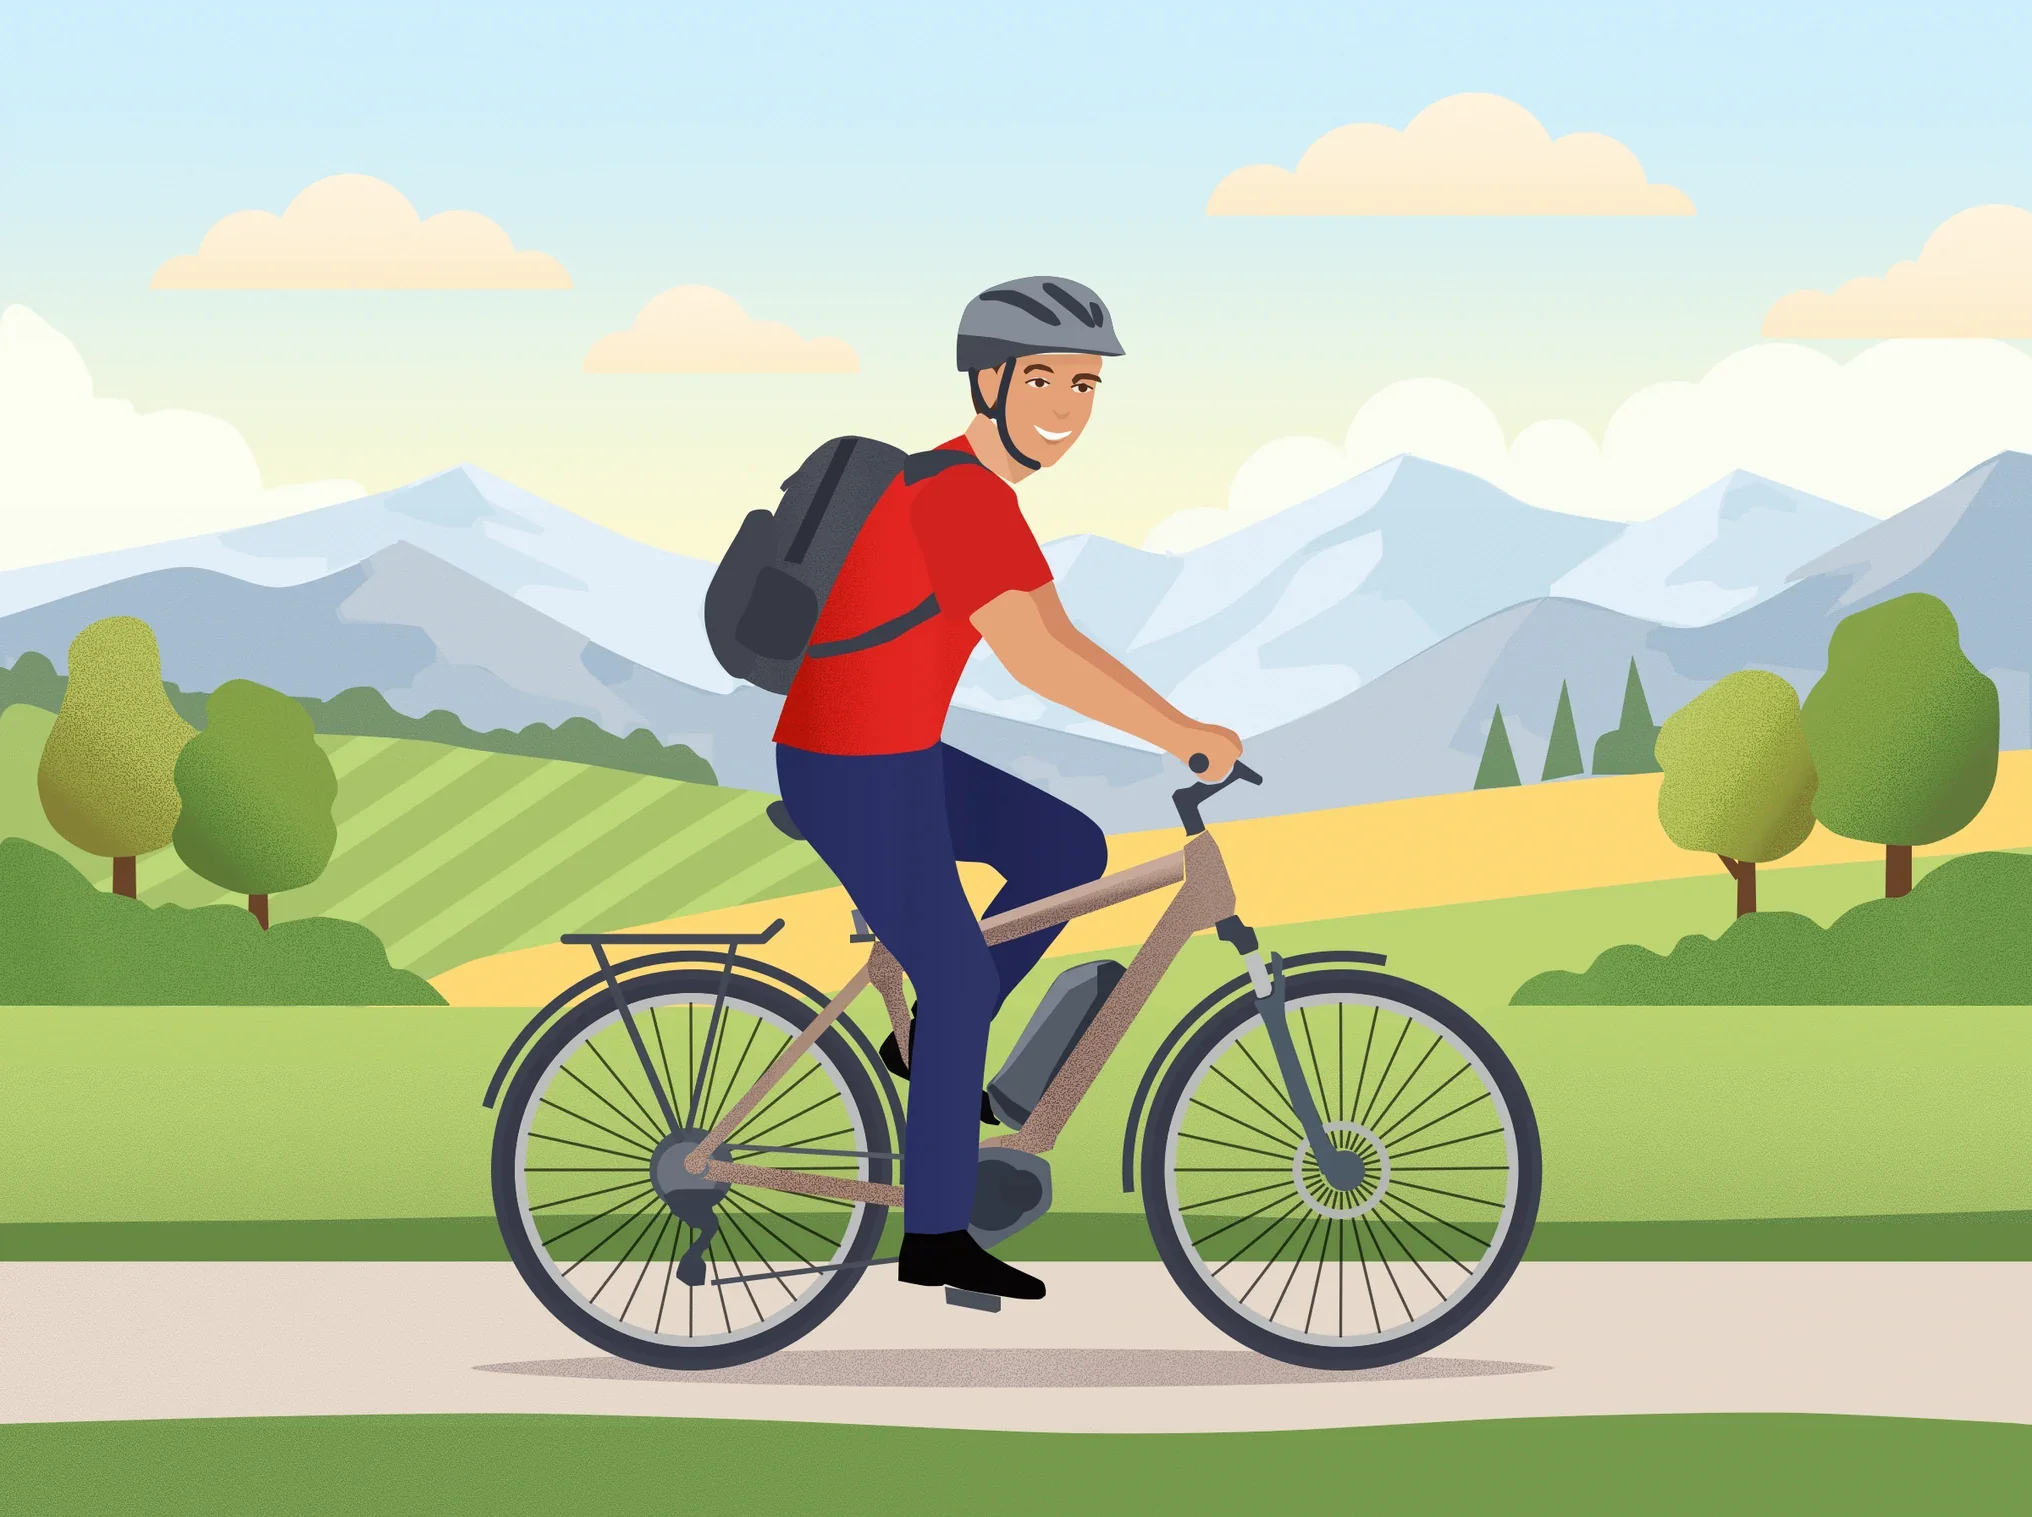
#7 Claude Sonnet 5.5 · high
70.2 Score $20.1 75 min passé Agentique
-
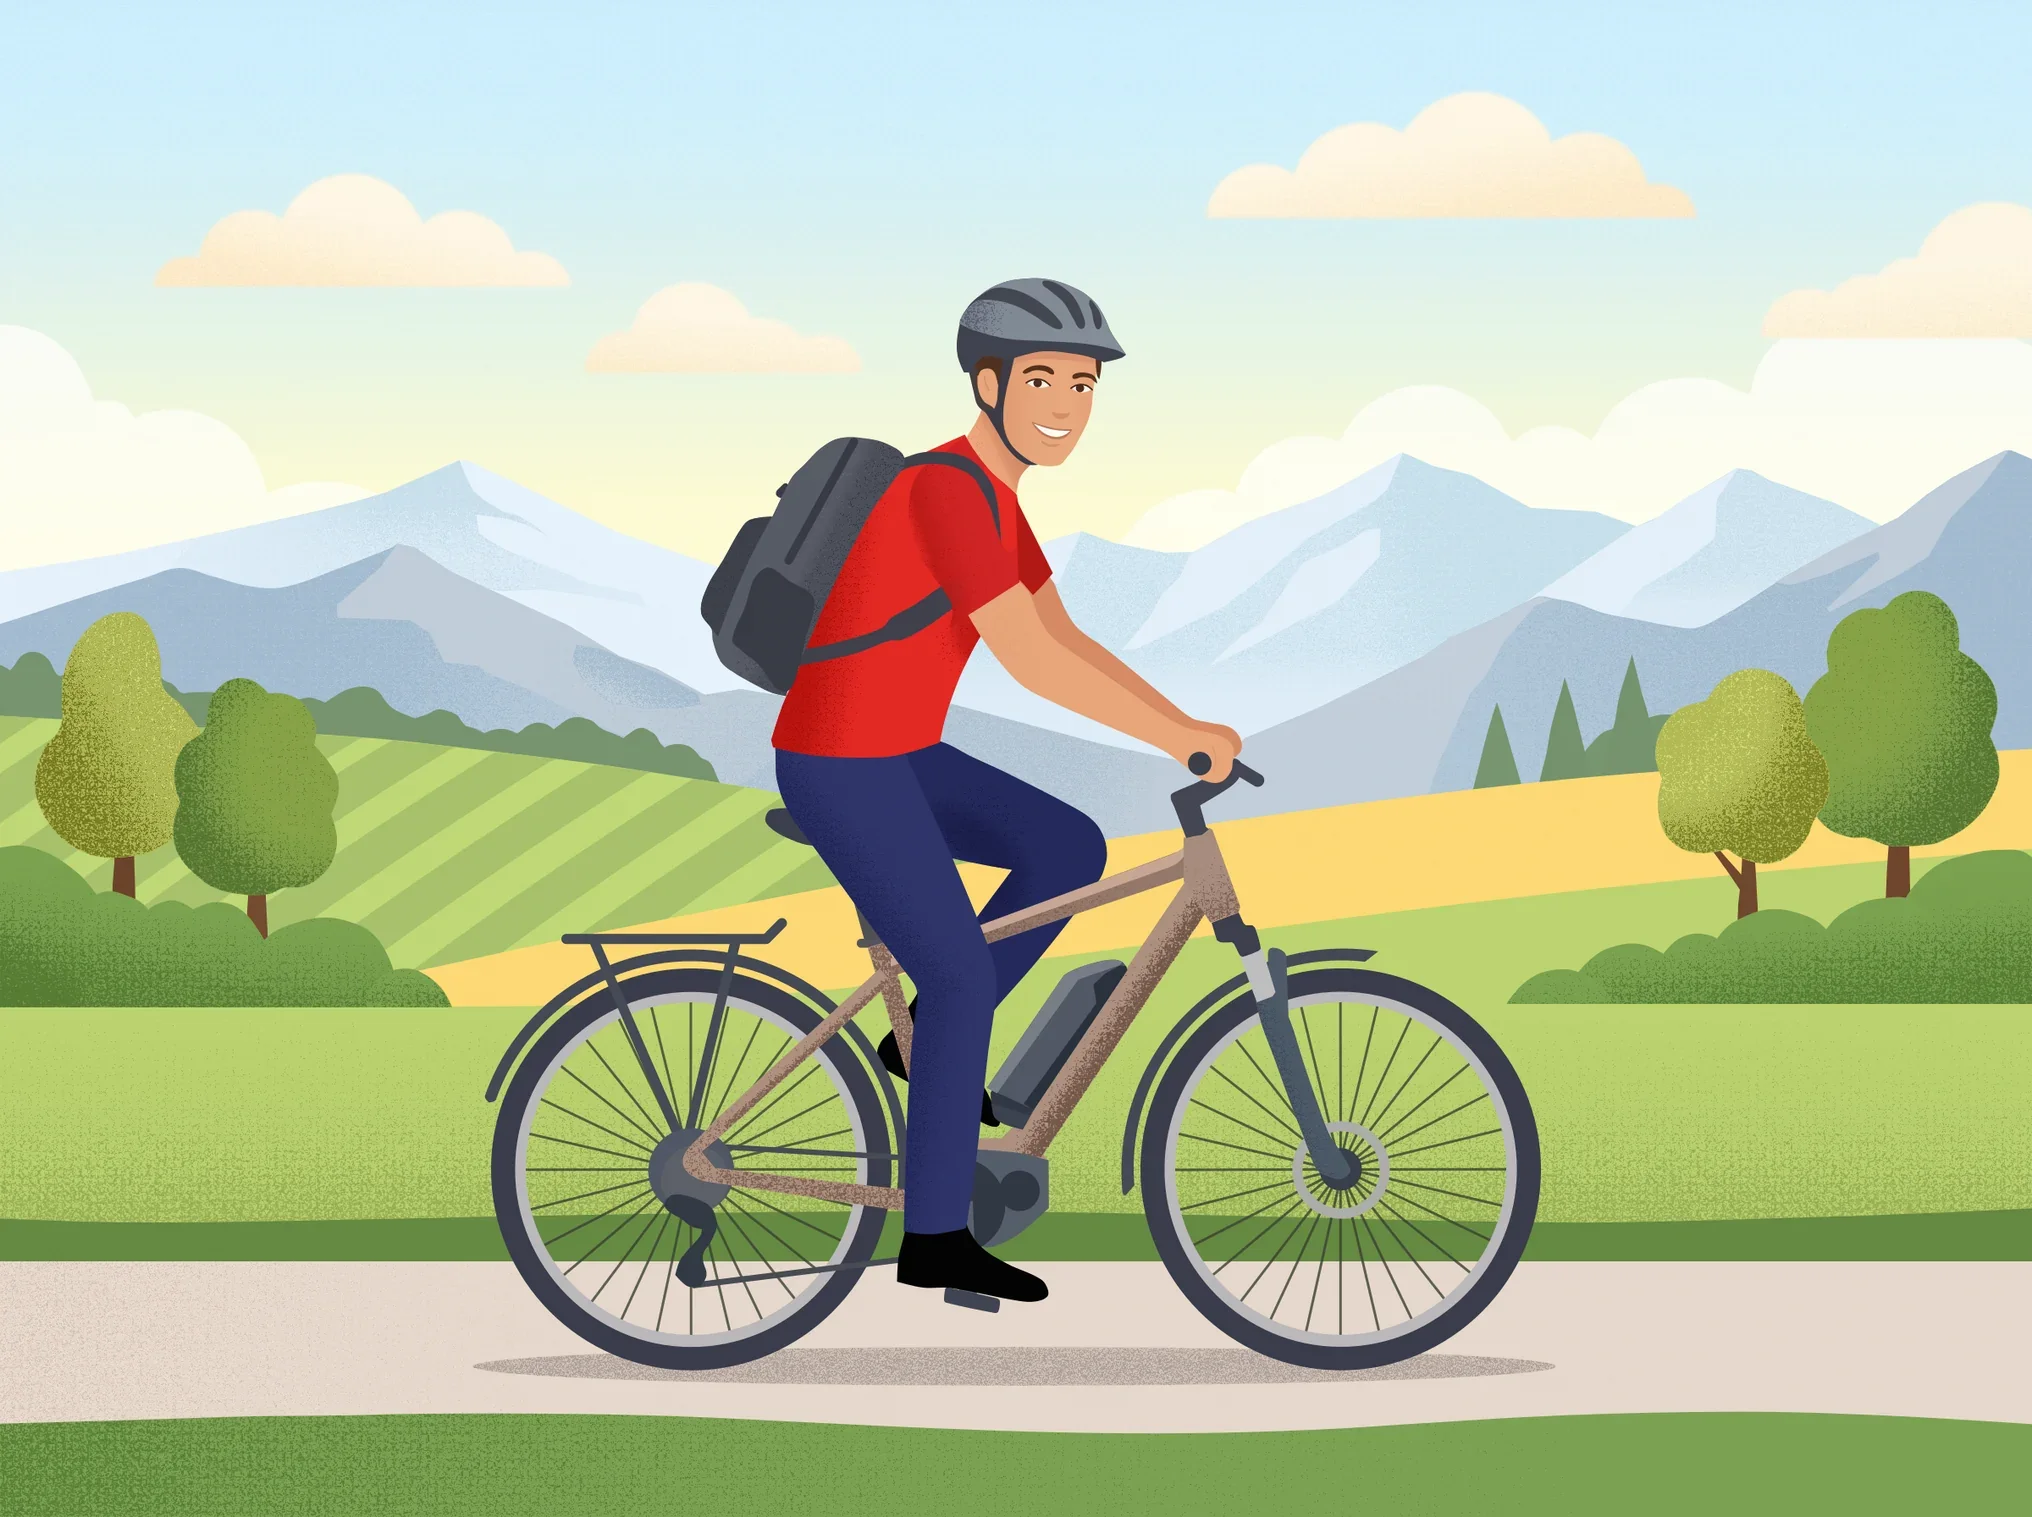
#8 Claude Fable 5.1 · xhigh Essai A/B
82.0 Score $117 96 min passé Agentique
Balade en vélo électrique : une exécution exploratoire de l’essai A/B, pas une exécution propre du protocole (exécutée avec une version antérieure du prompt, interrompue une fois puis reprise, travail délégué à des sous-agents et sur une version antérieure de l’agent). Elle est classée comme tout autre résultat ; une répétition selon le protocole est en attente.
-
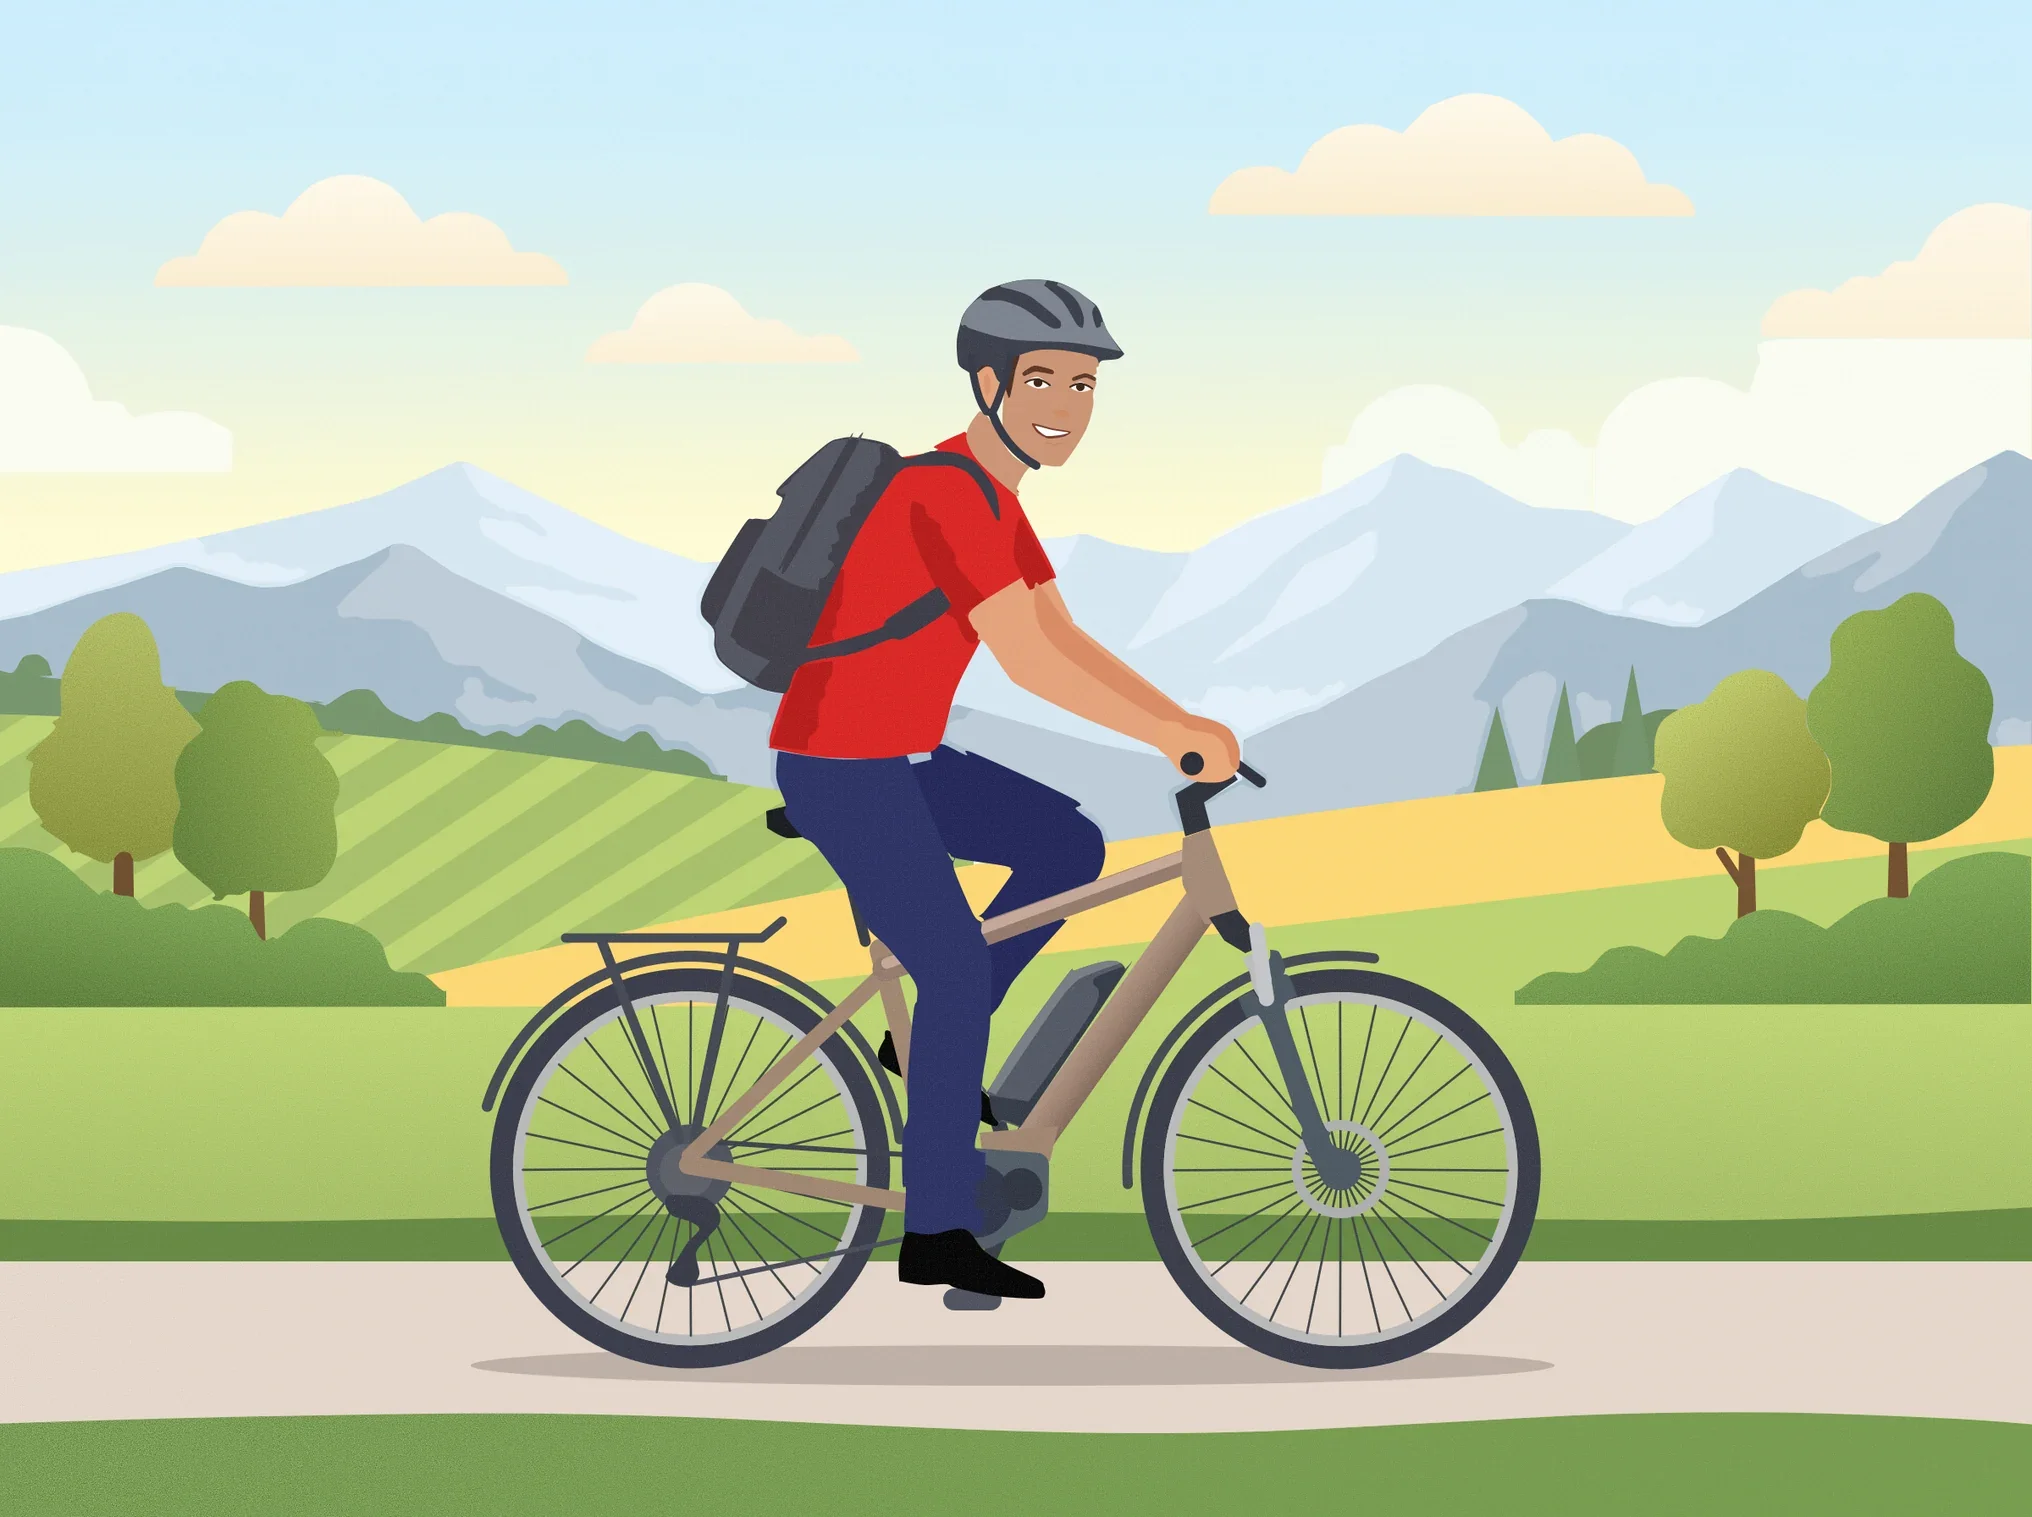
#9 Claude Opus 5.5 · medium
67.4 Score $16.4 91 min passé Agentique
-
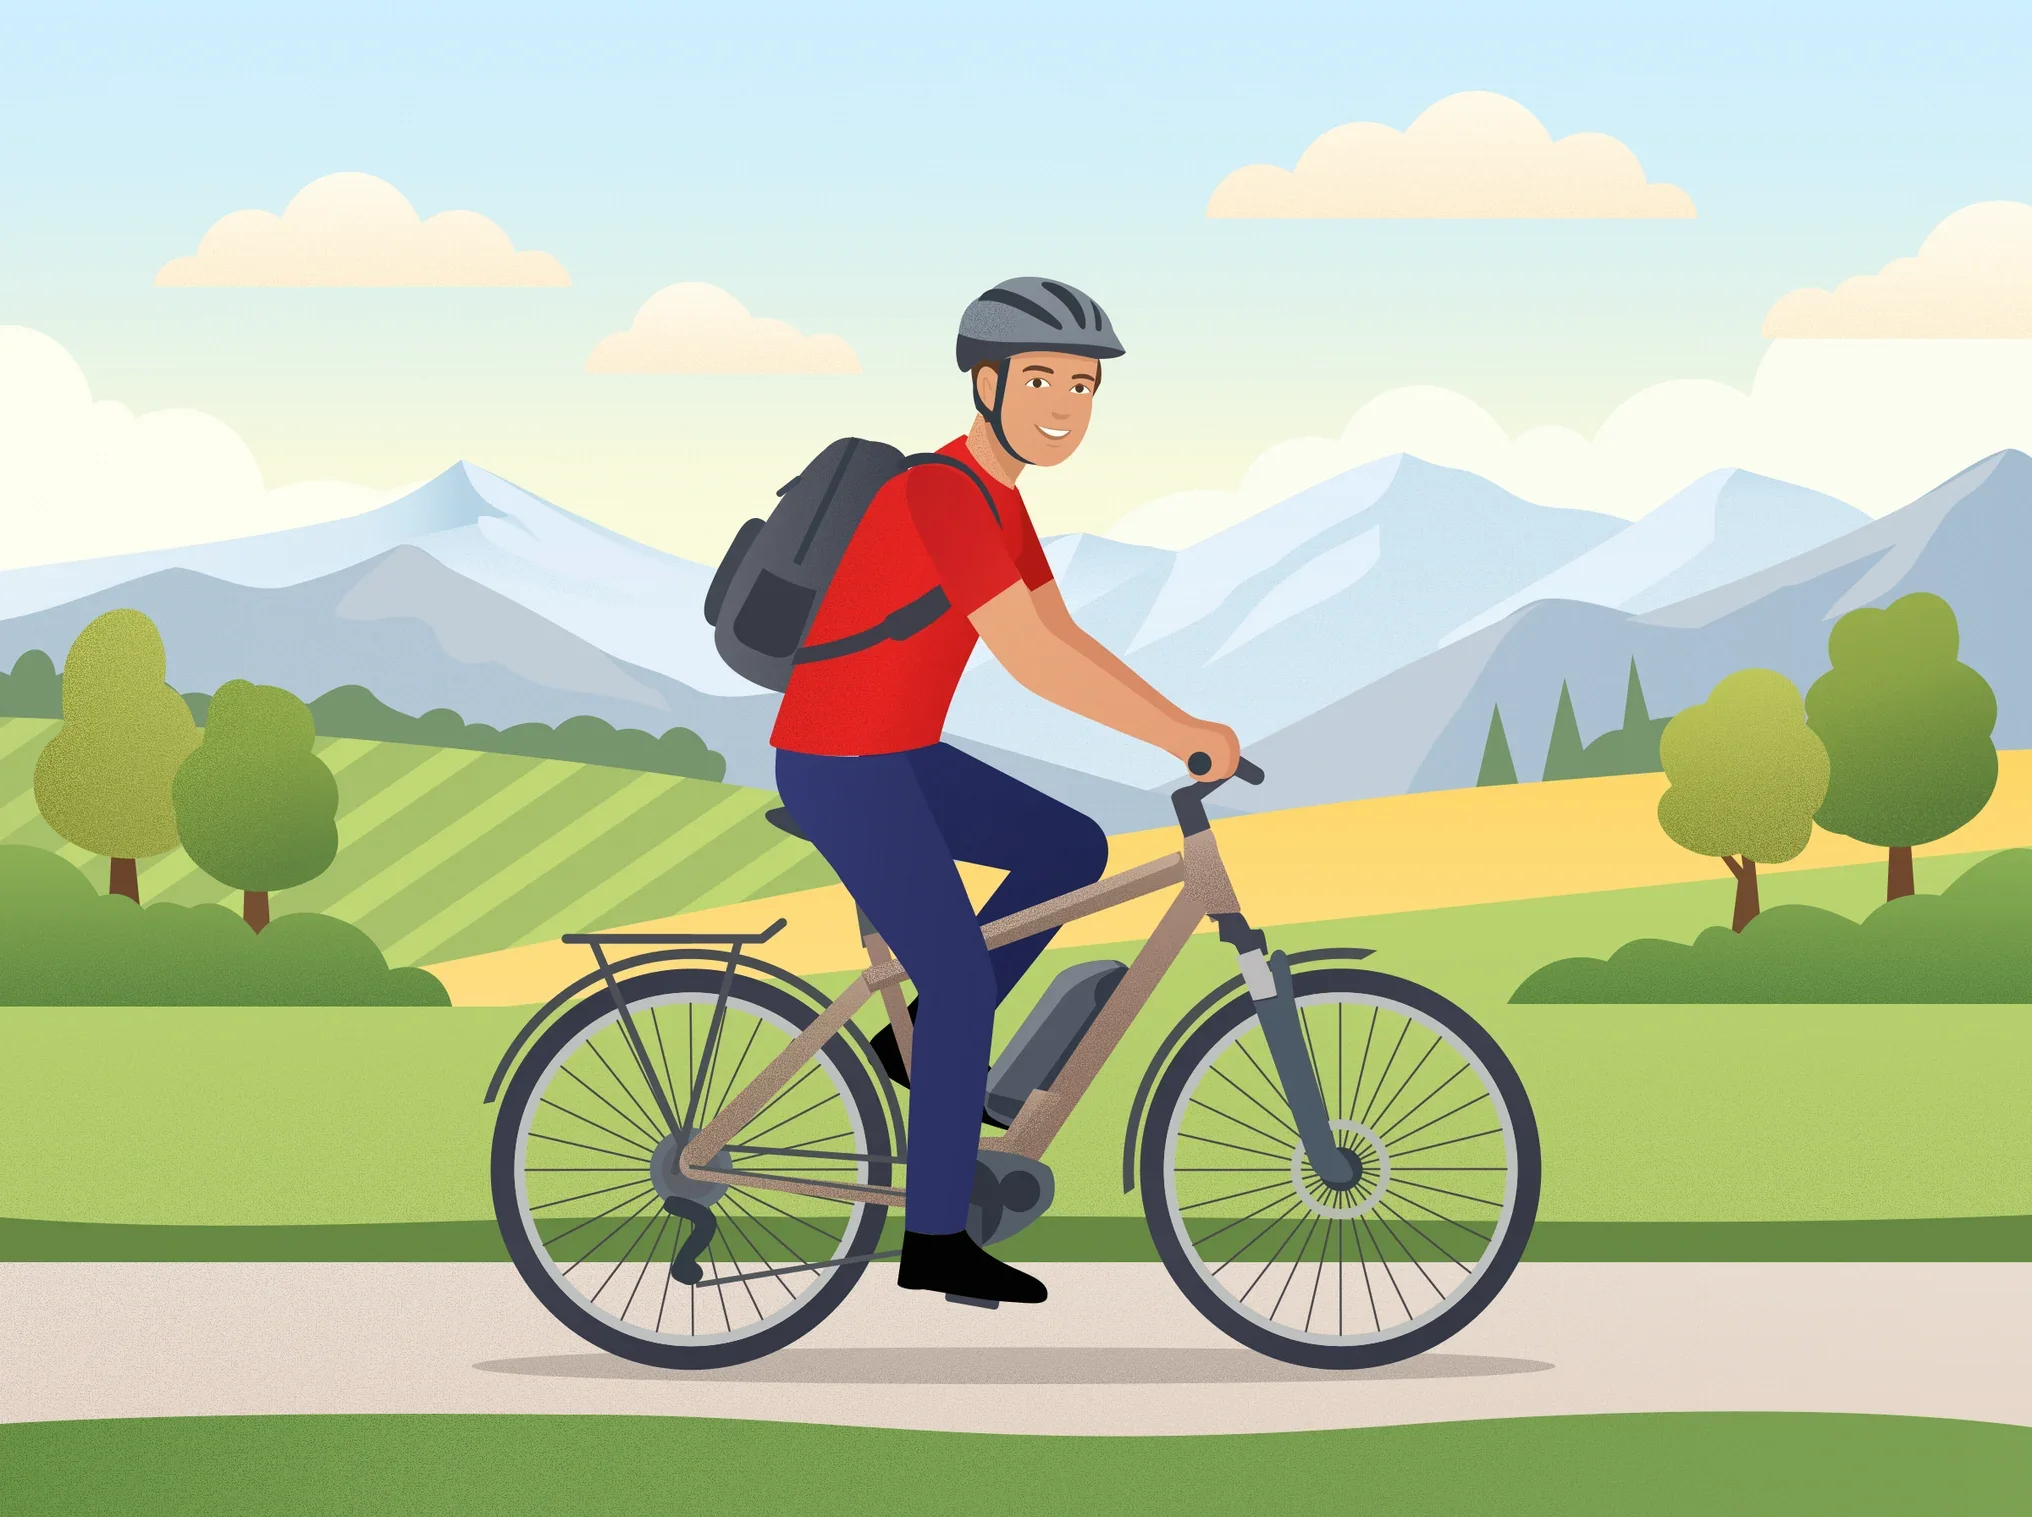
#10 GPT 6.1 Sol · medium
72.2 Score $8.2 86 min passé Agentique
-
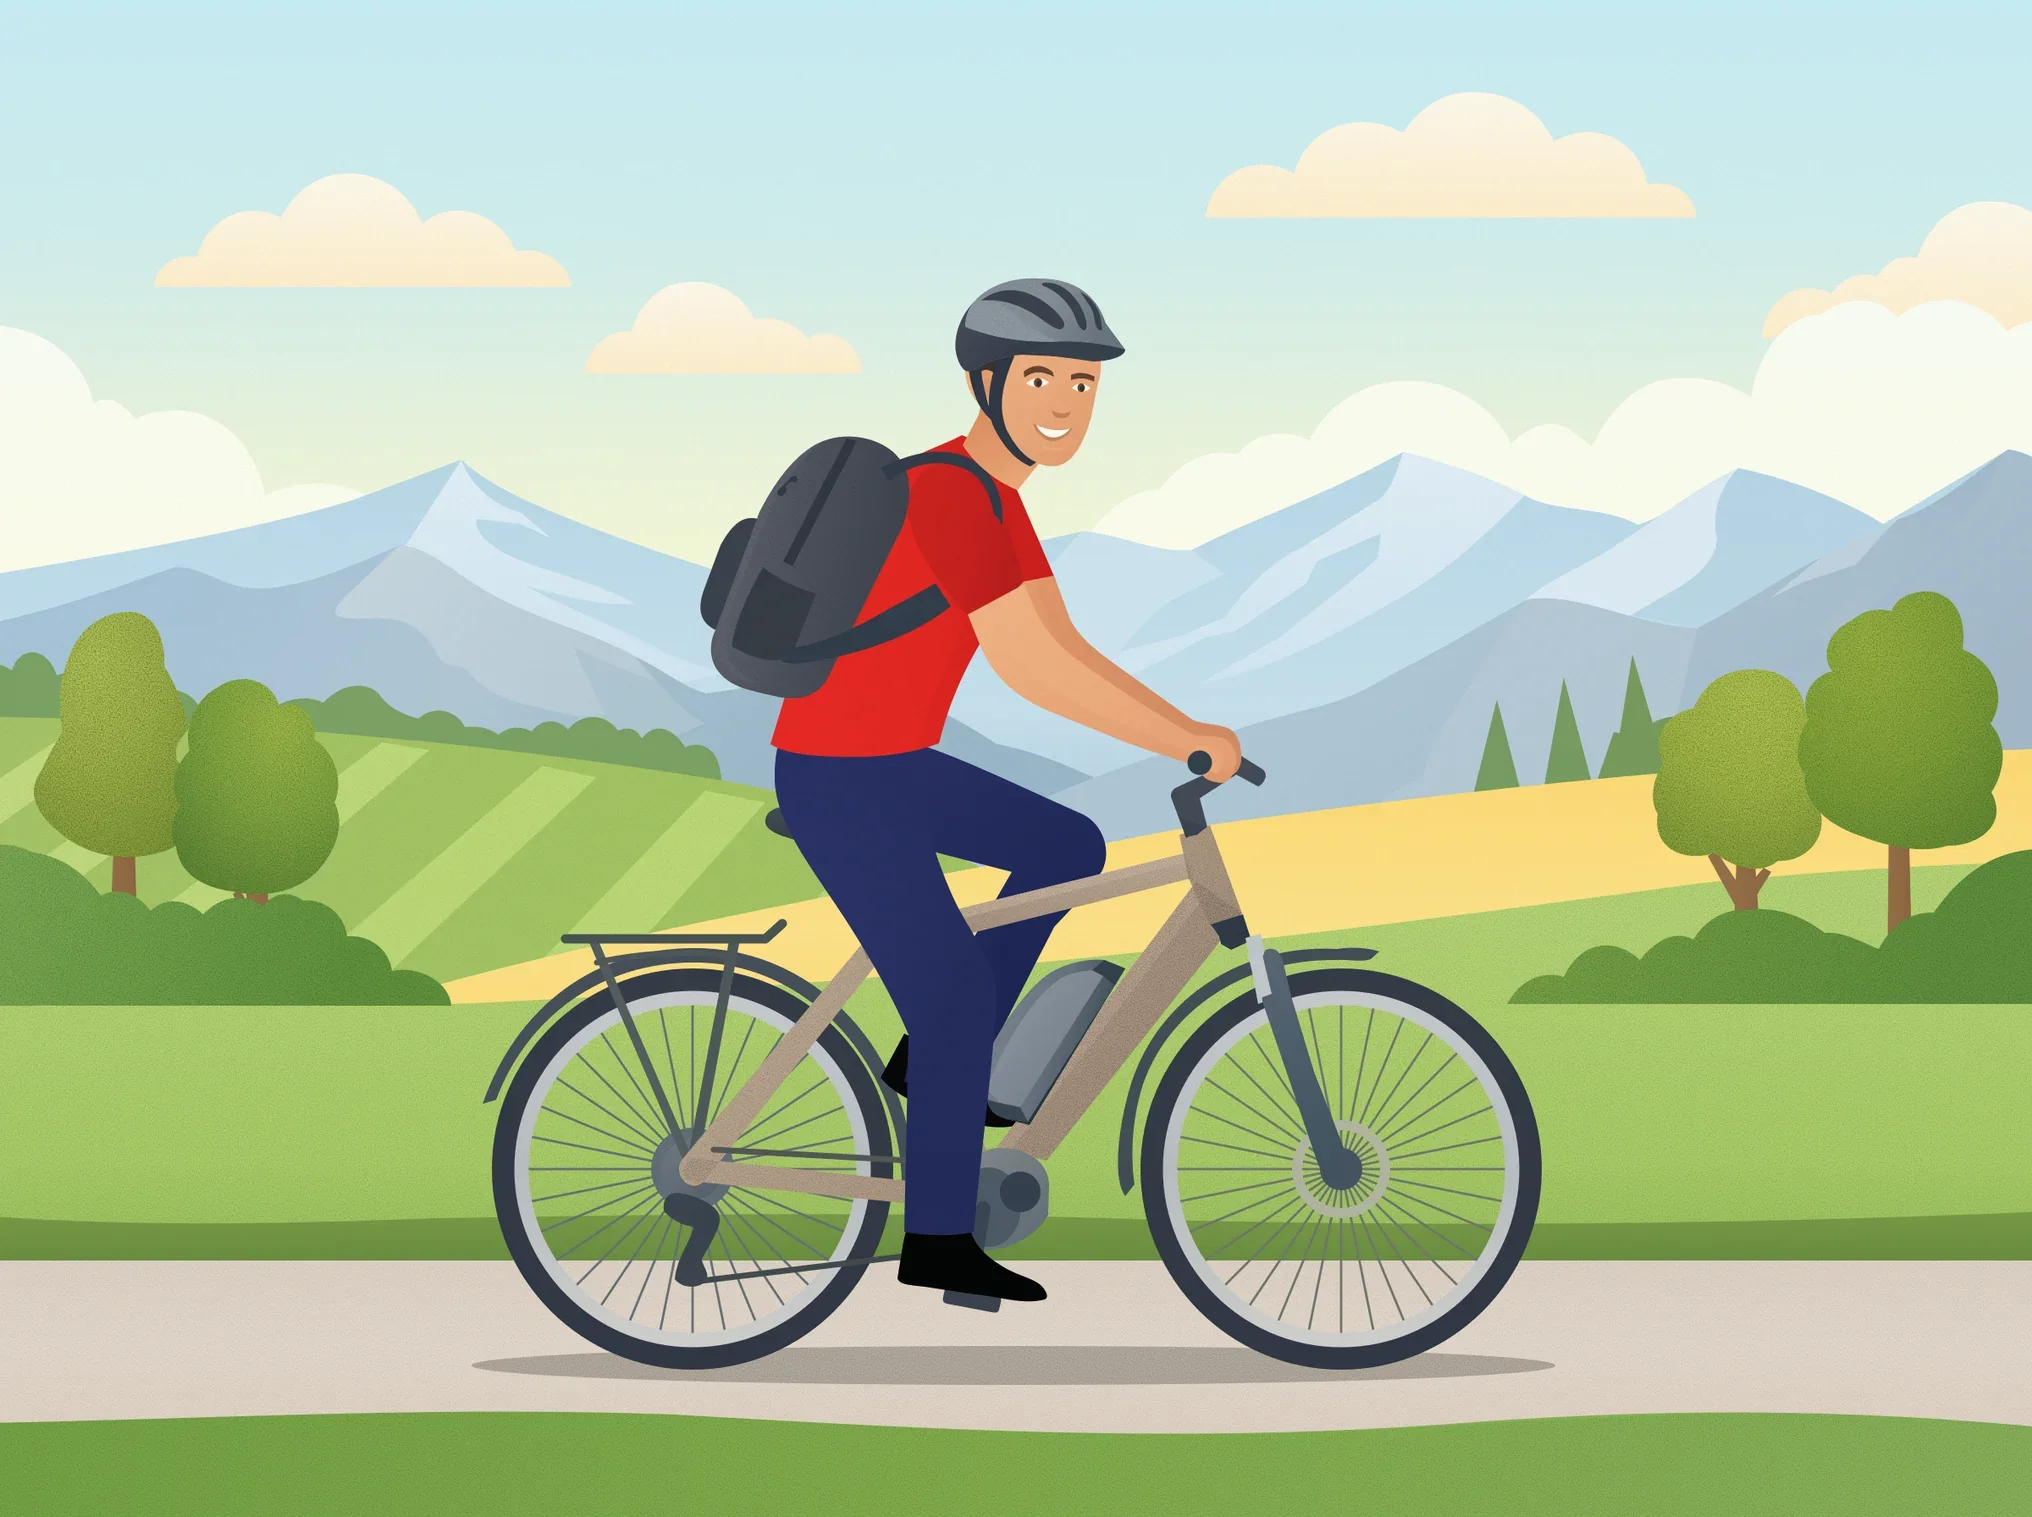
#11 GPT 6.1 Sol · xhigh
48.0 Score $0.38 15 min échoué Single-shot
-
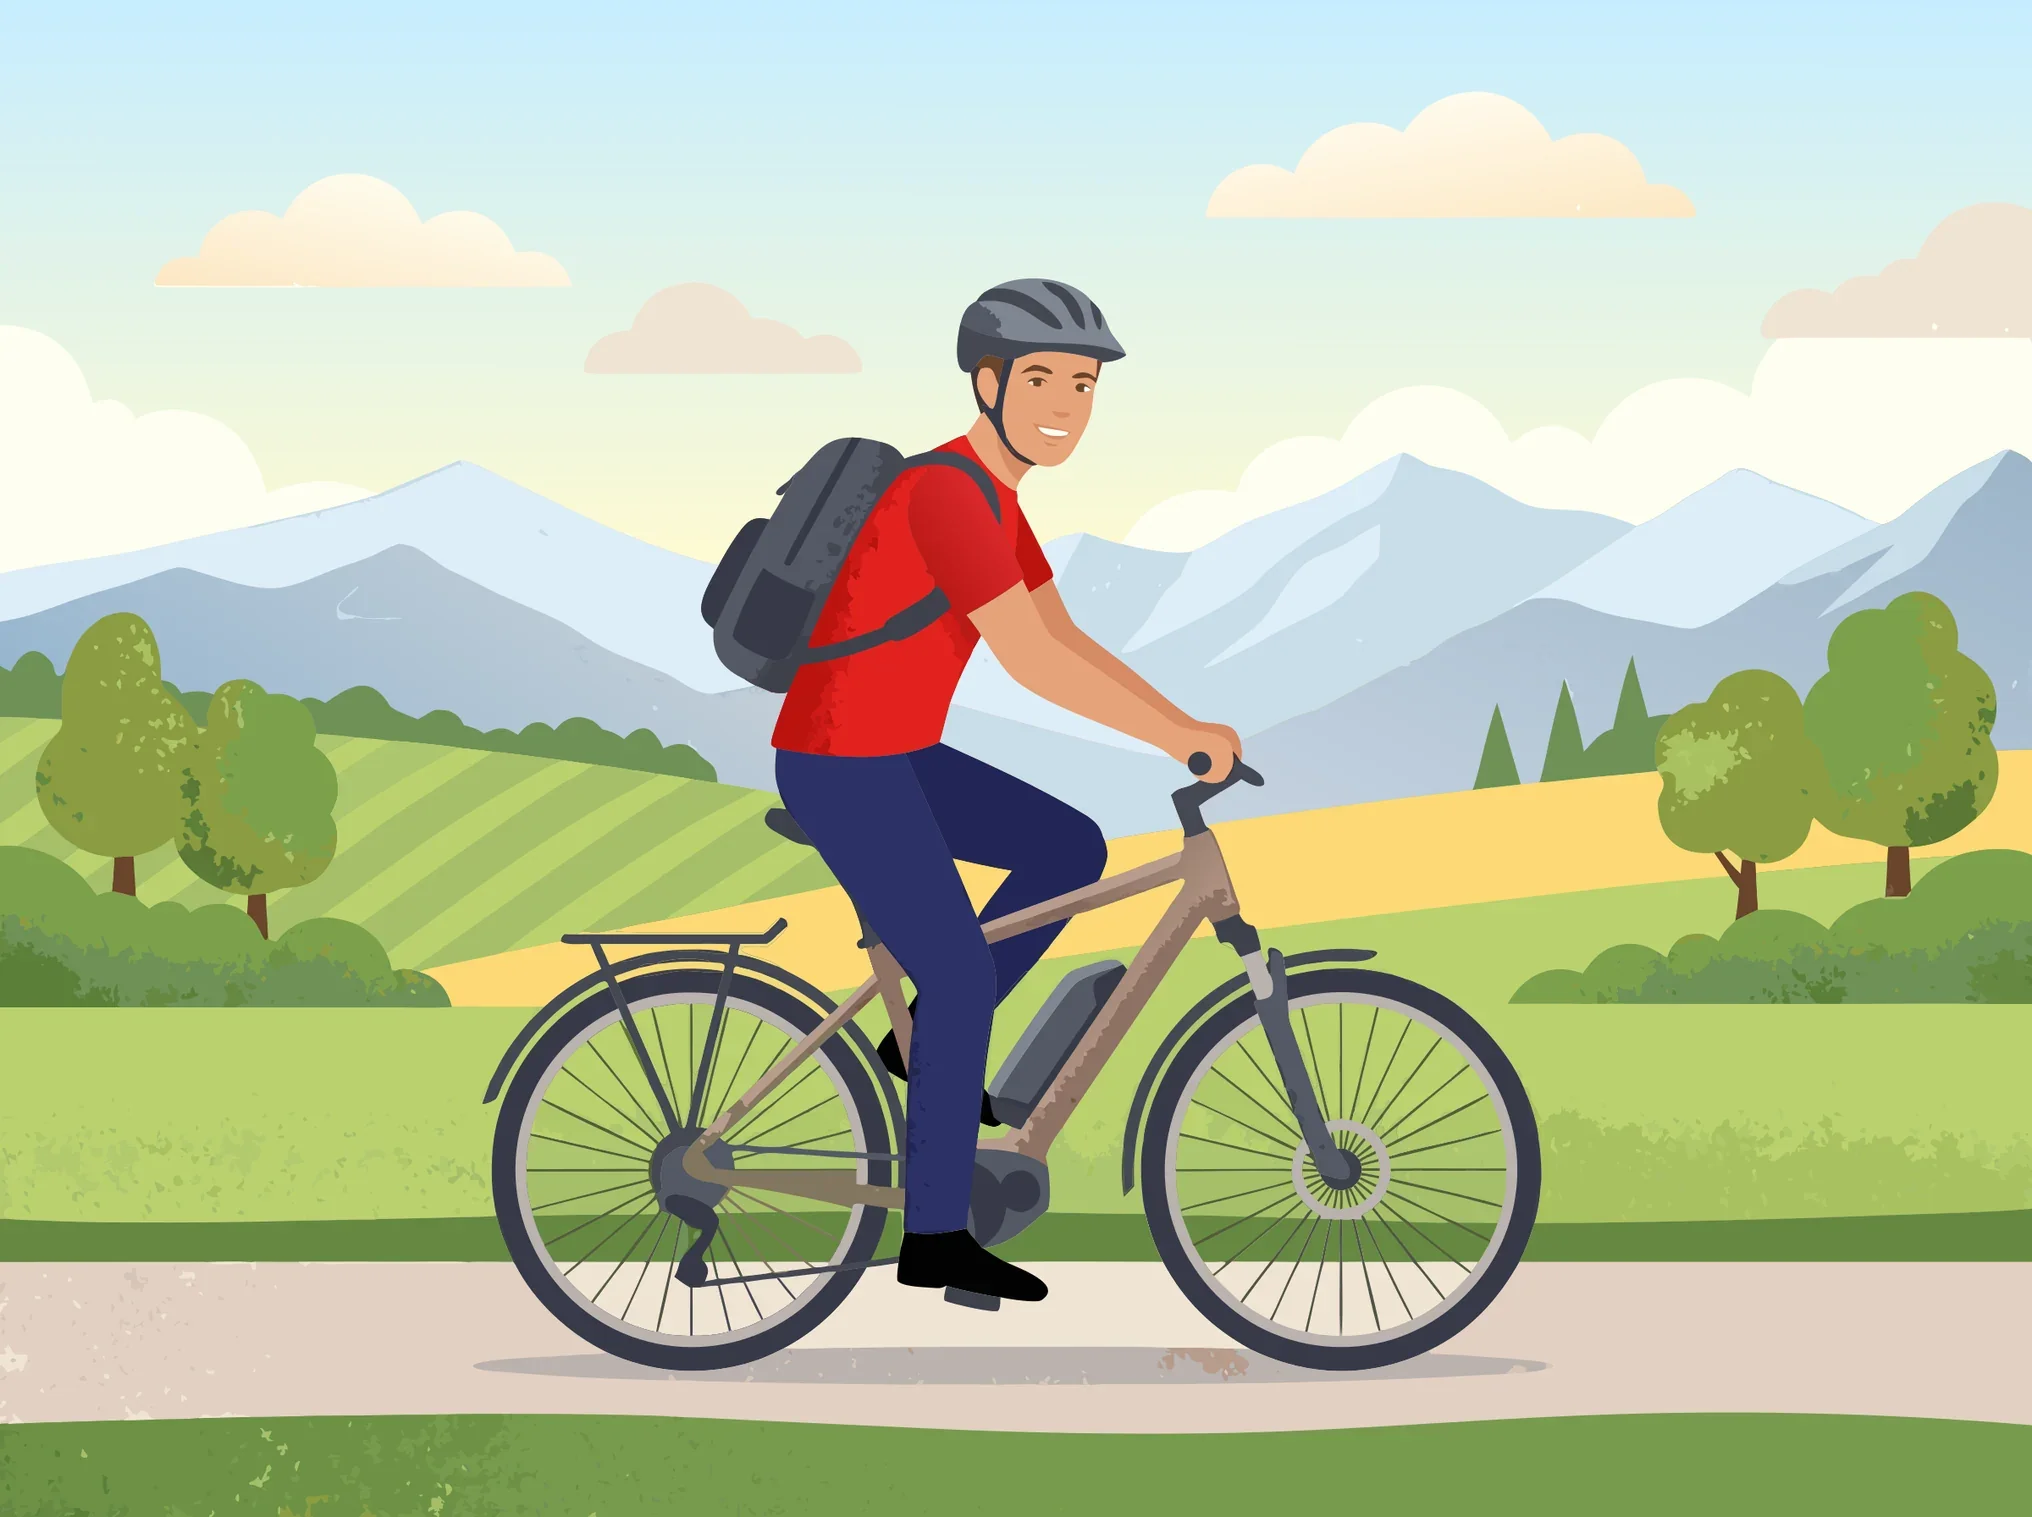
#12 Recraft Vectorize
42.0 Score $0.01 non chronométré échoué Outil
-
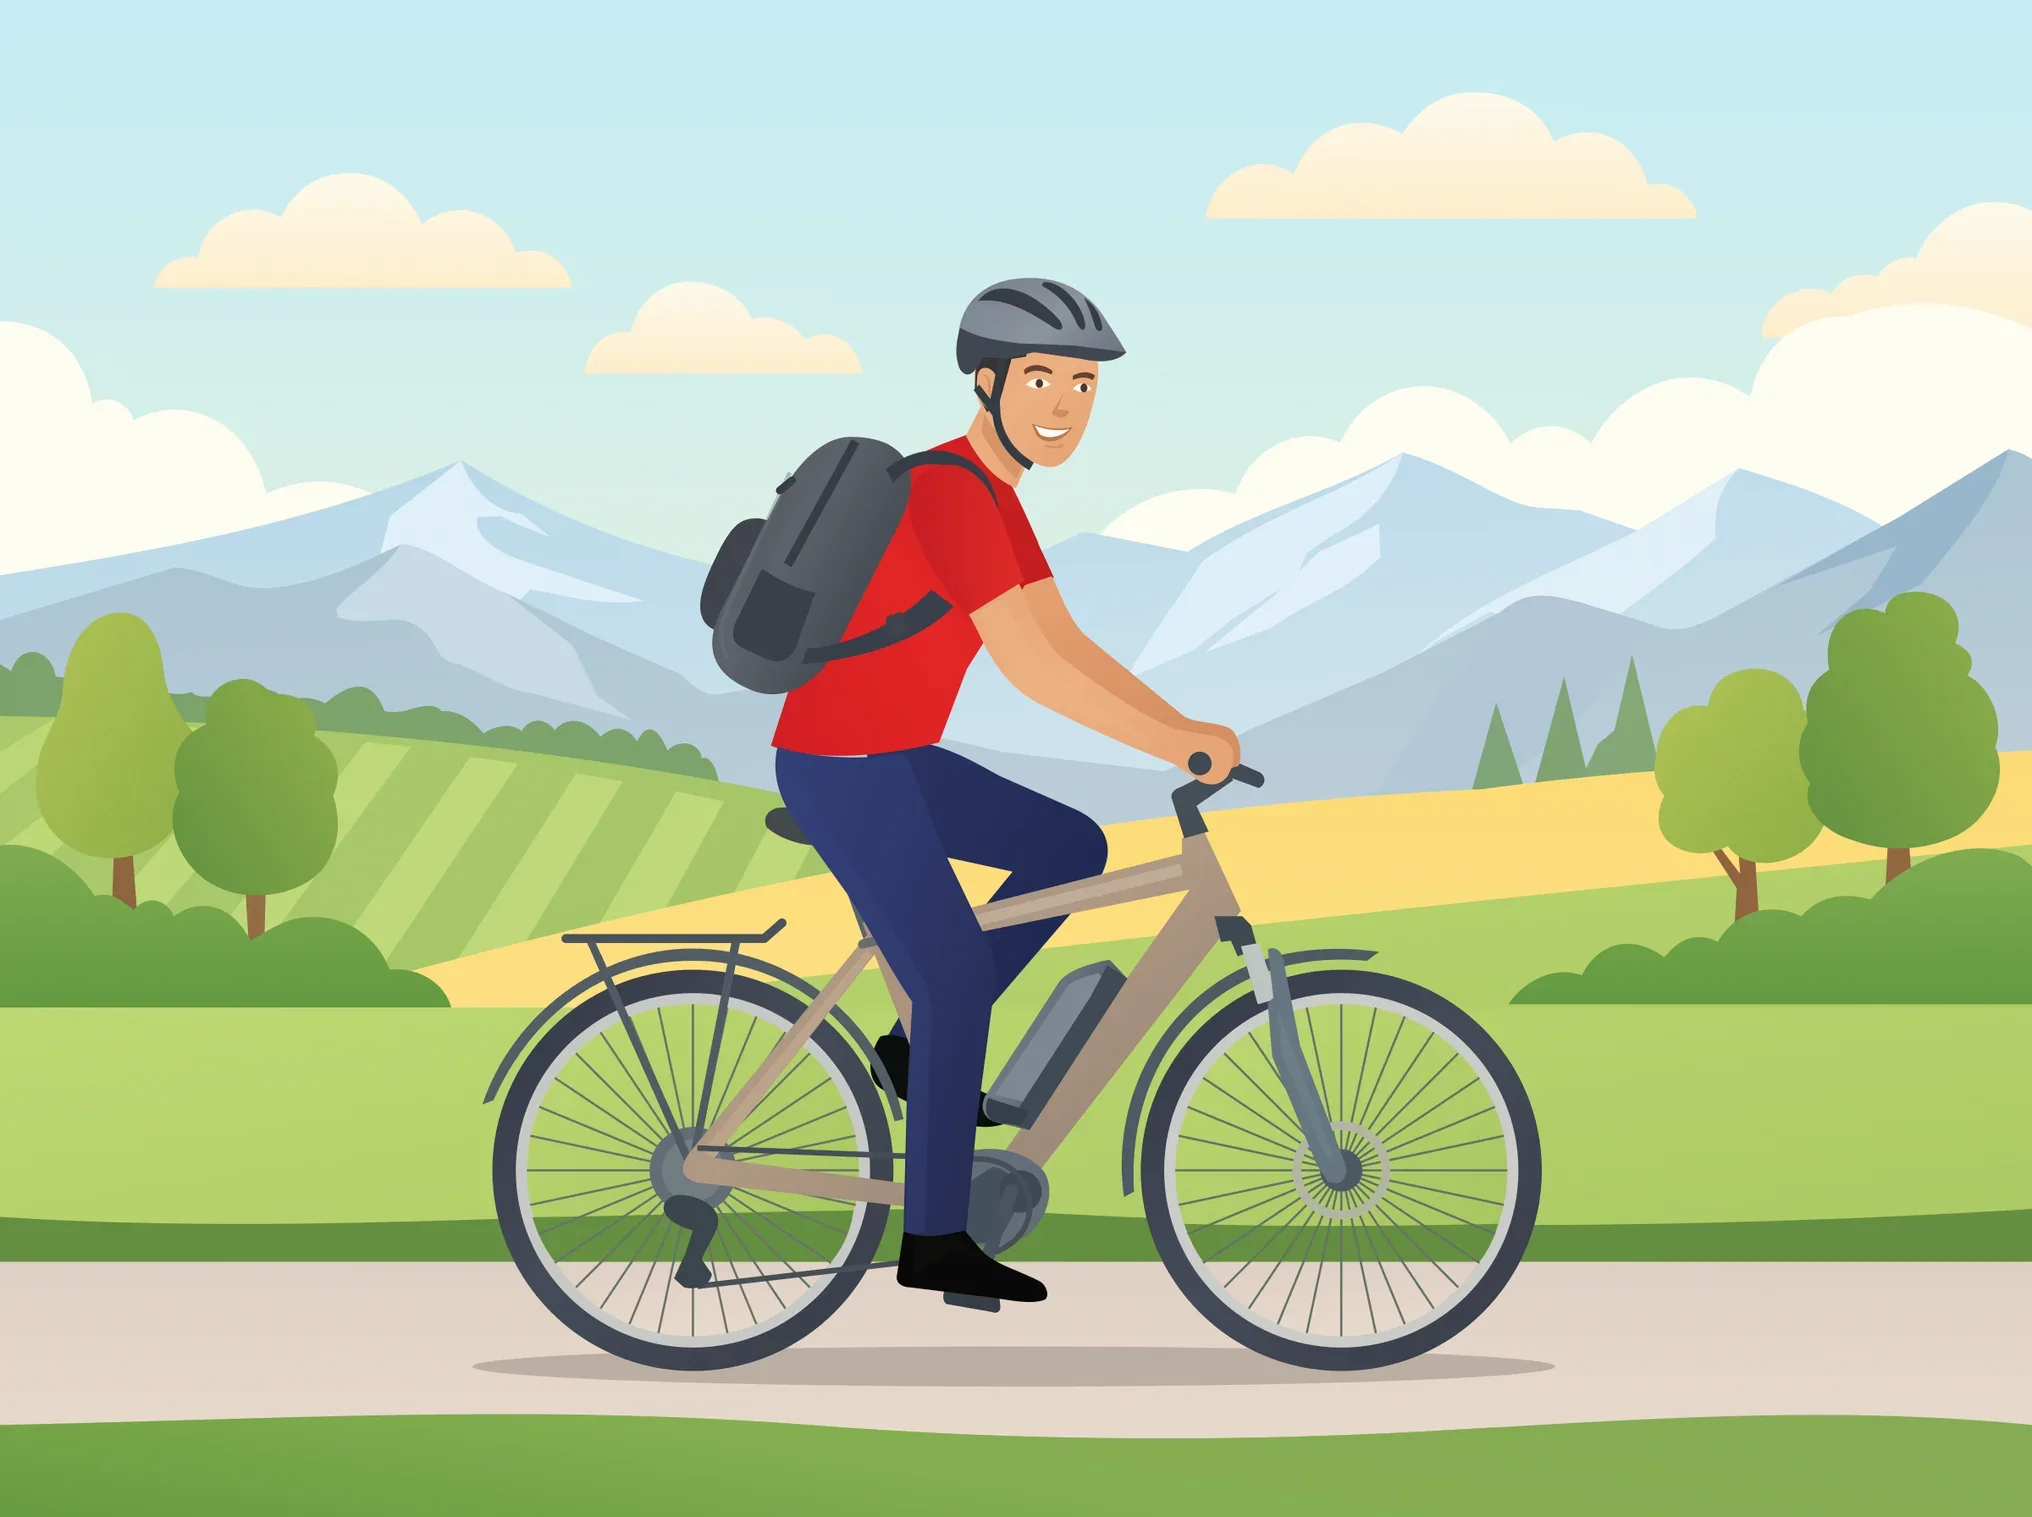
#13 GPT 6.1 Sol · medium
45.5 Score $0.21 6.9 min échoué Single-shot
-
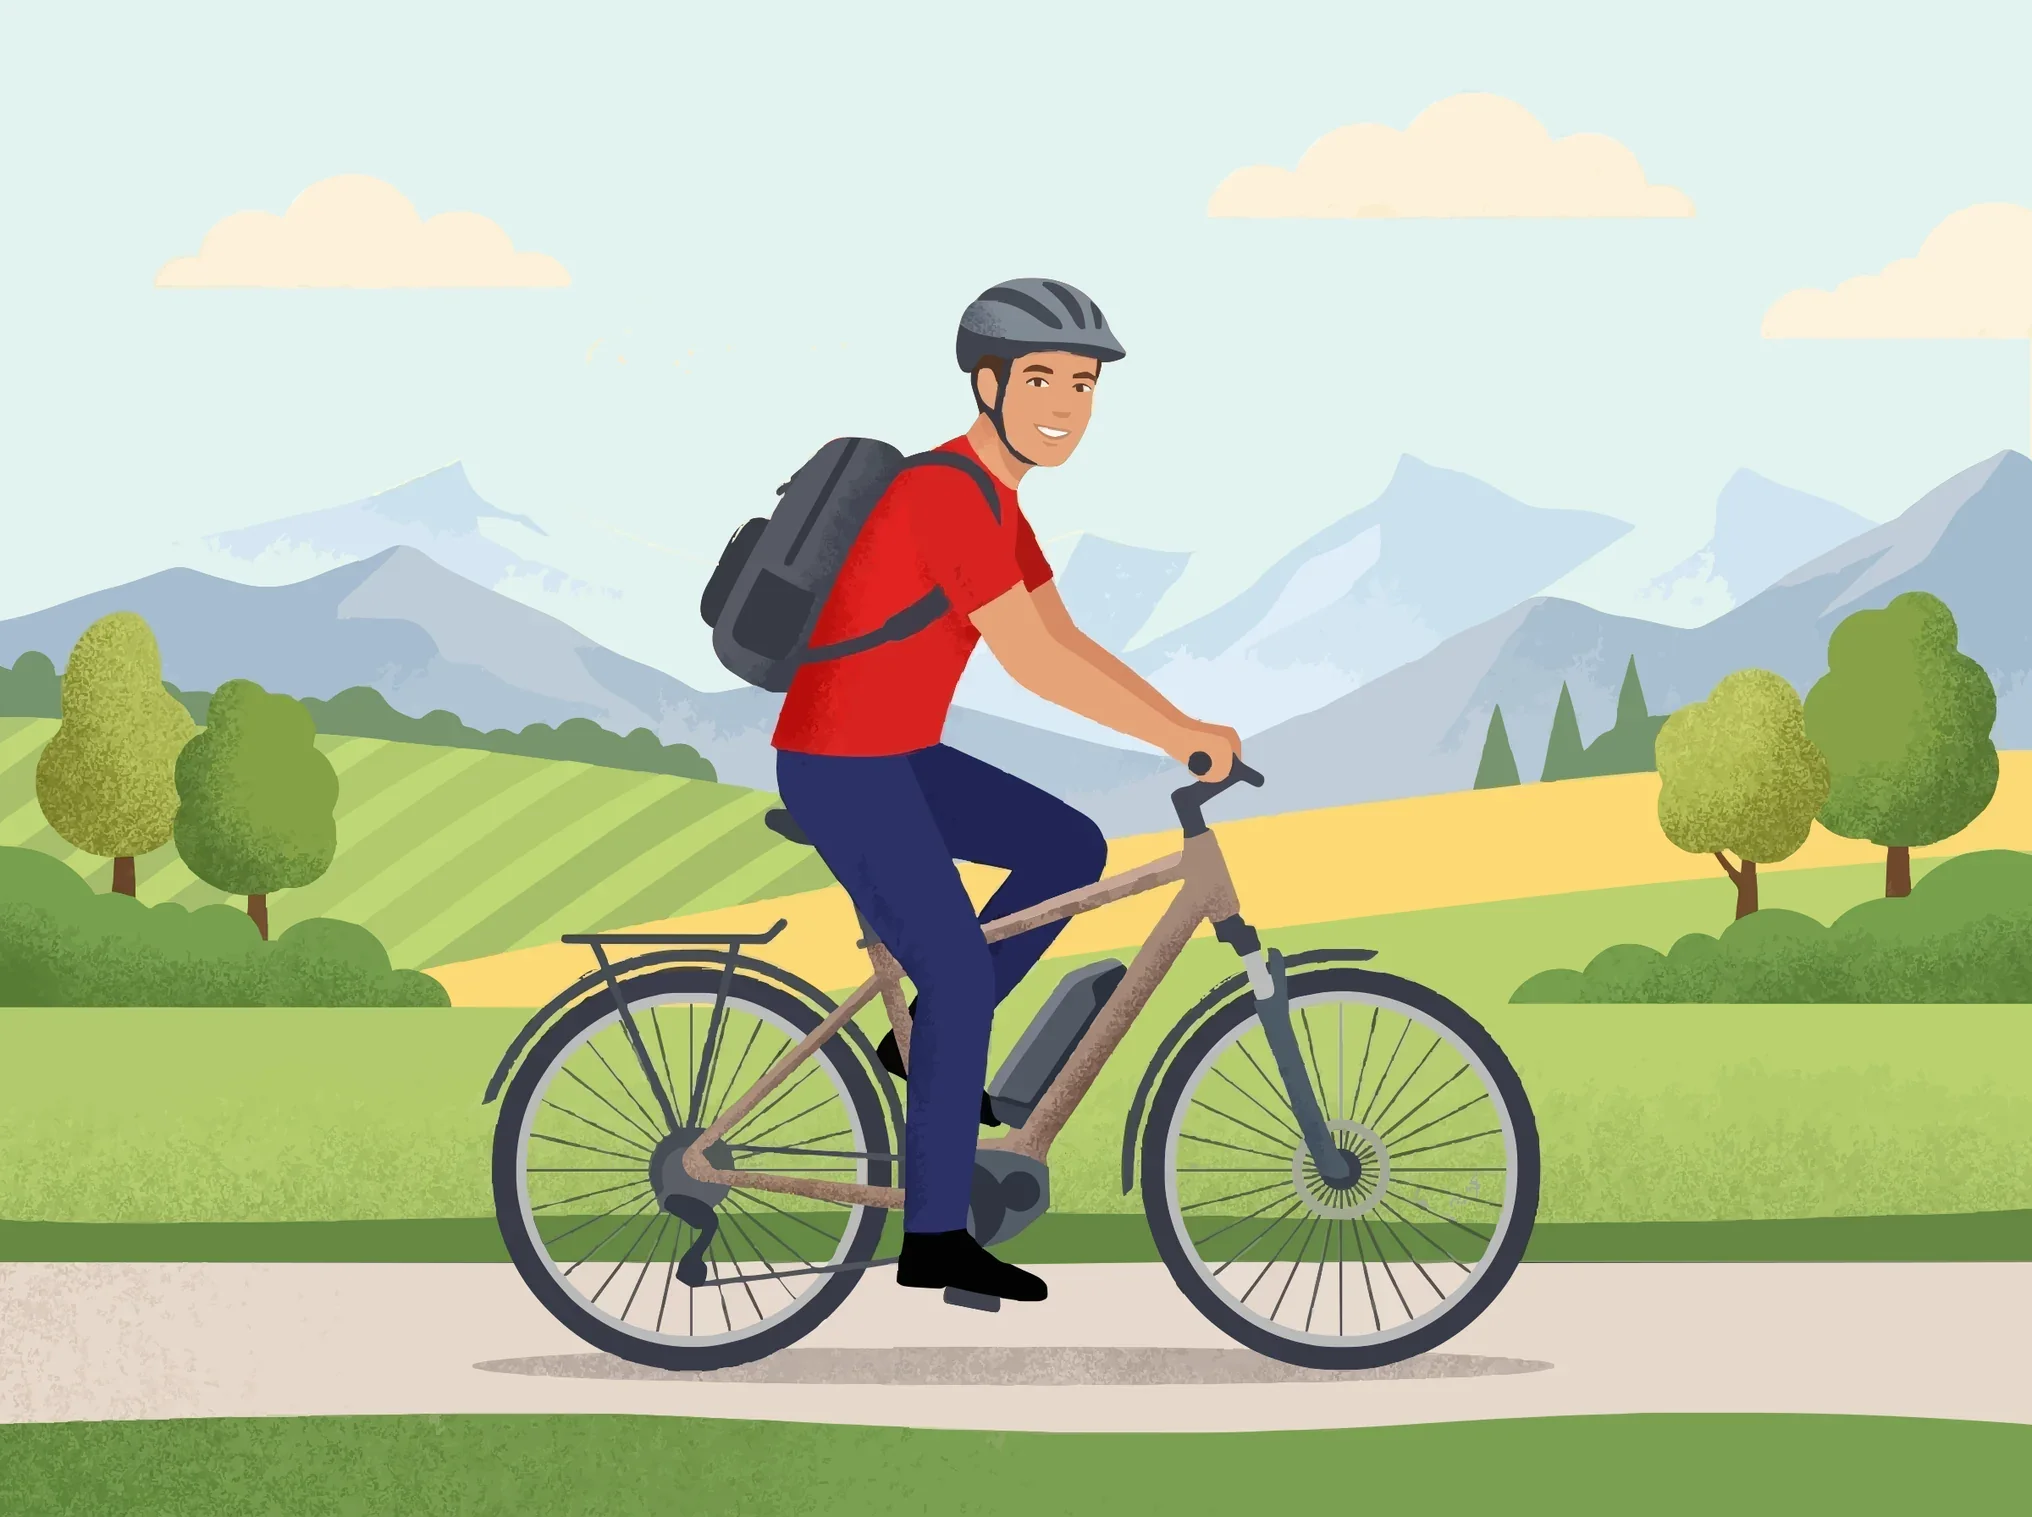
#14 vtracer 0.6.15, default settings
36.5 Score $0.00 0.1 min échoué Outil
-
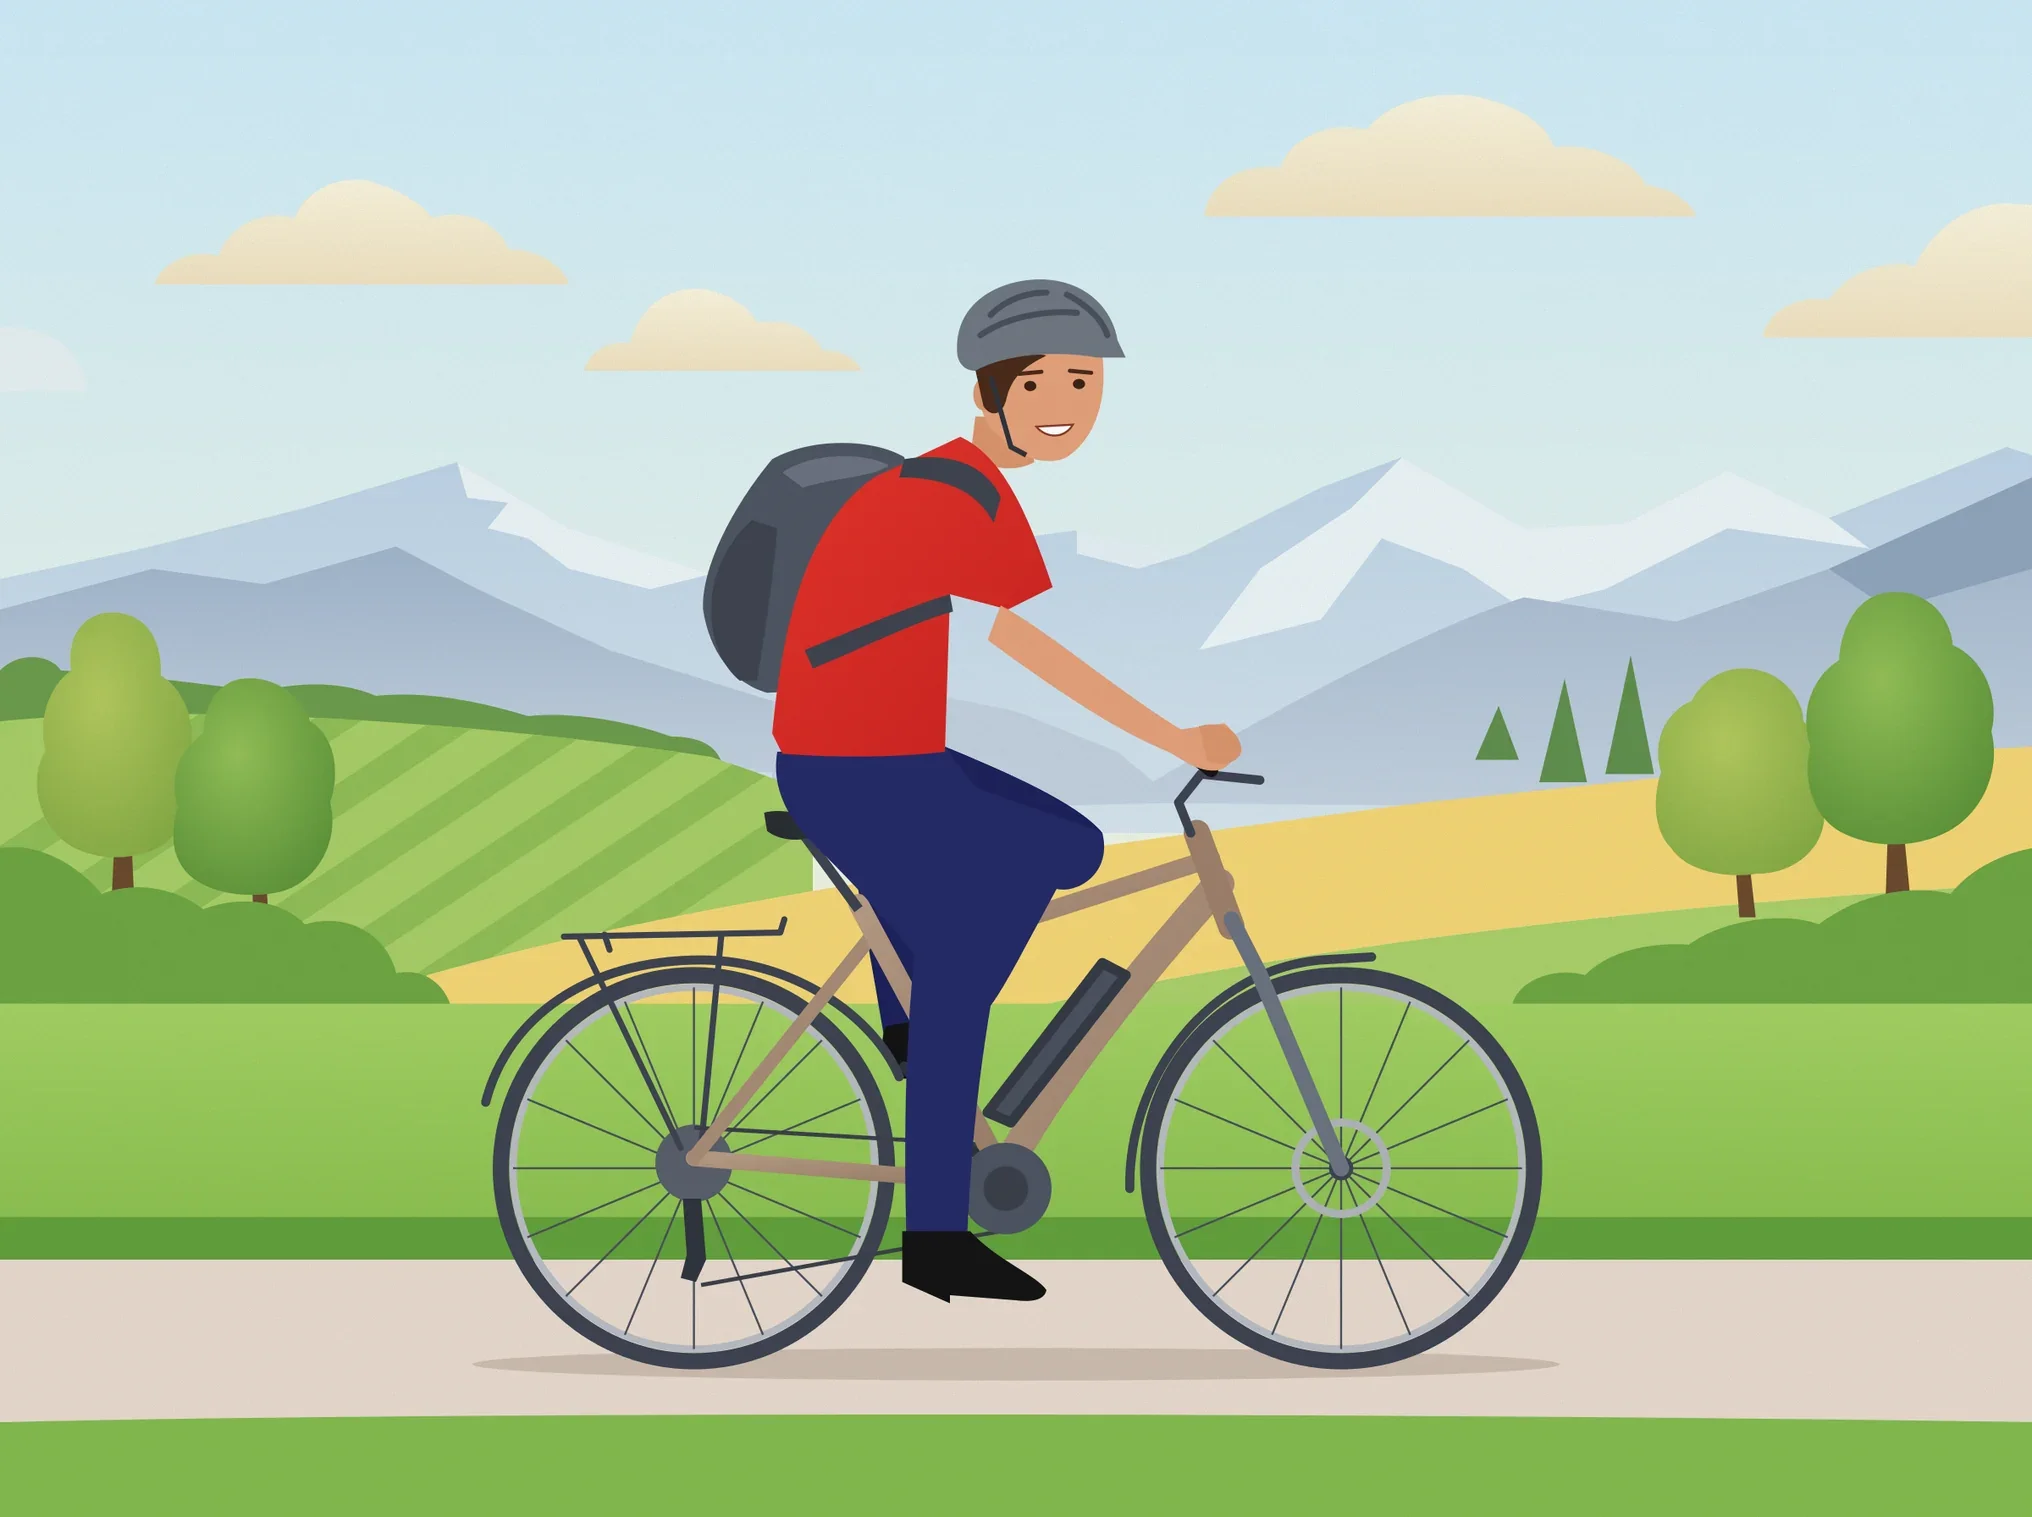
#15 Claude Opus 5.5 · medium
40.0 Score $2.1 14 min échoué Boucle fixe
-
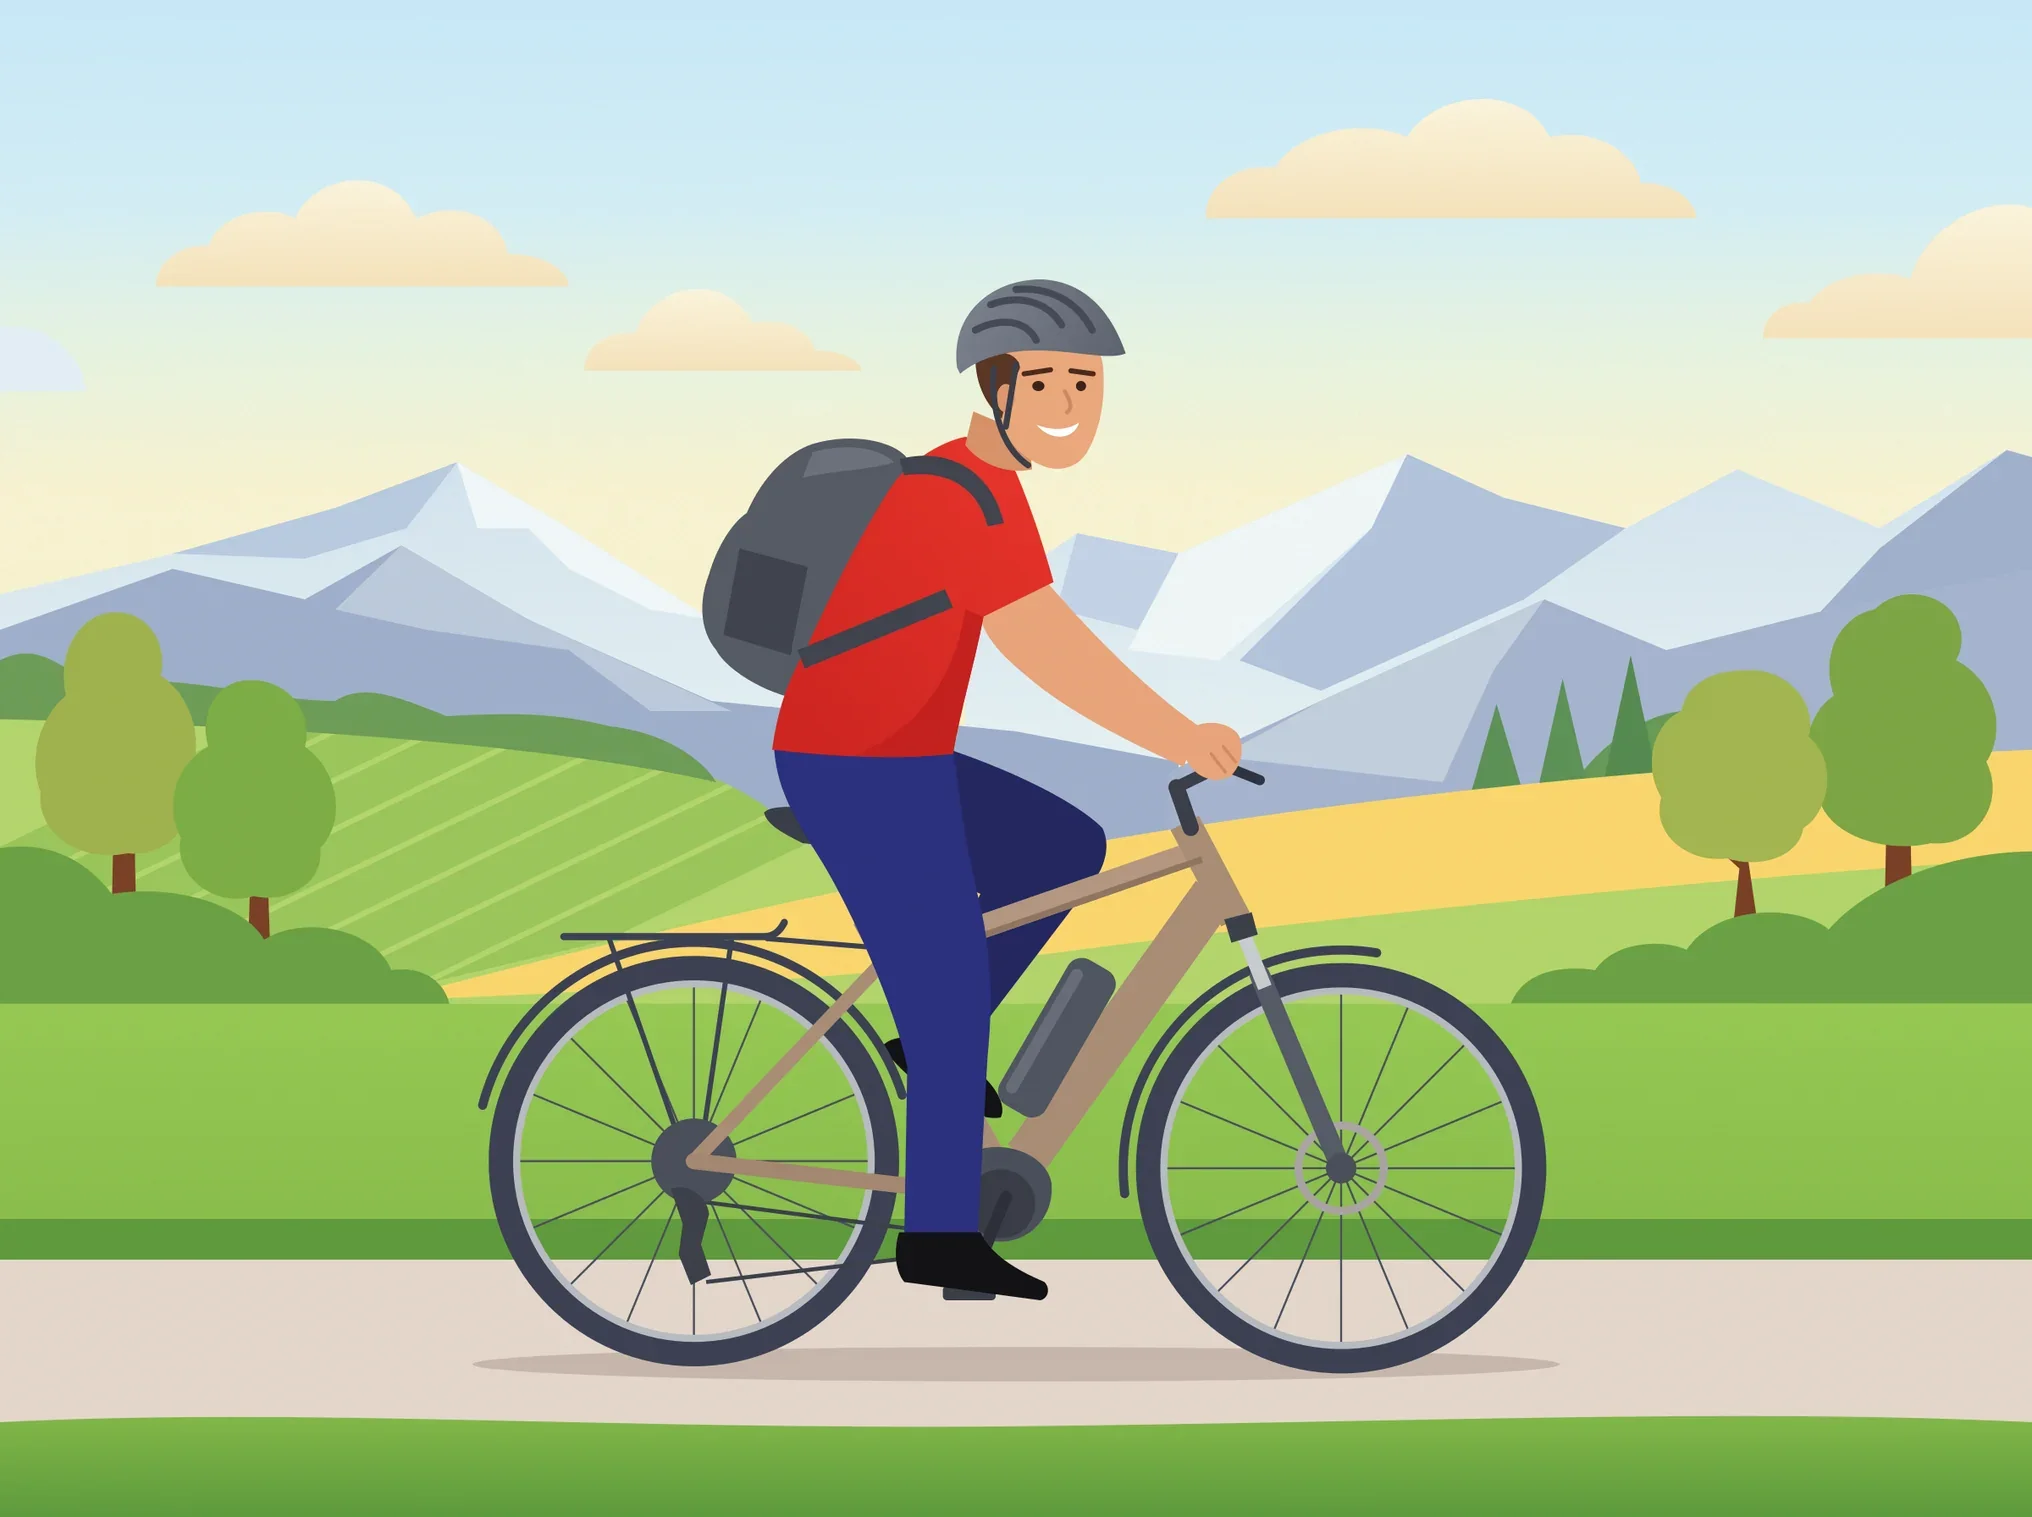
#16 Claude Fable 5.1 · medium
39.4 Score $1.2 4.4 min échoué Single-shot
-
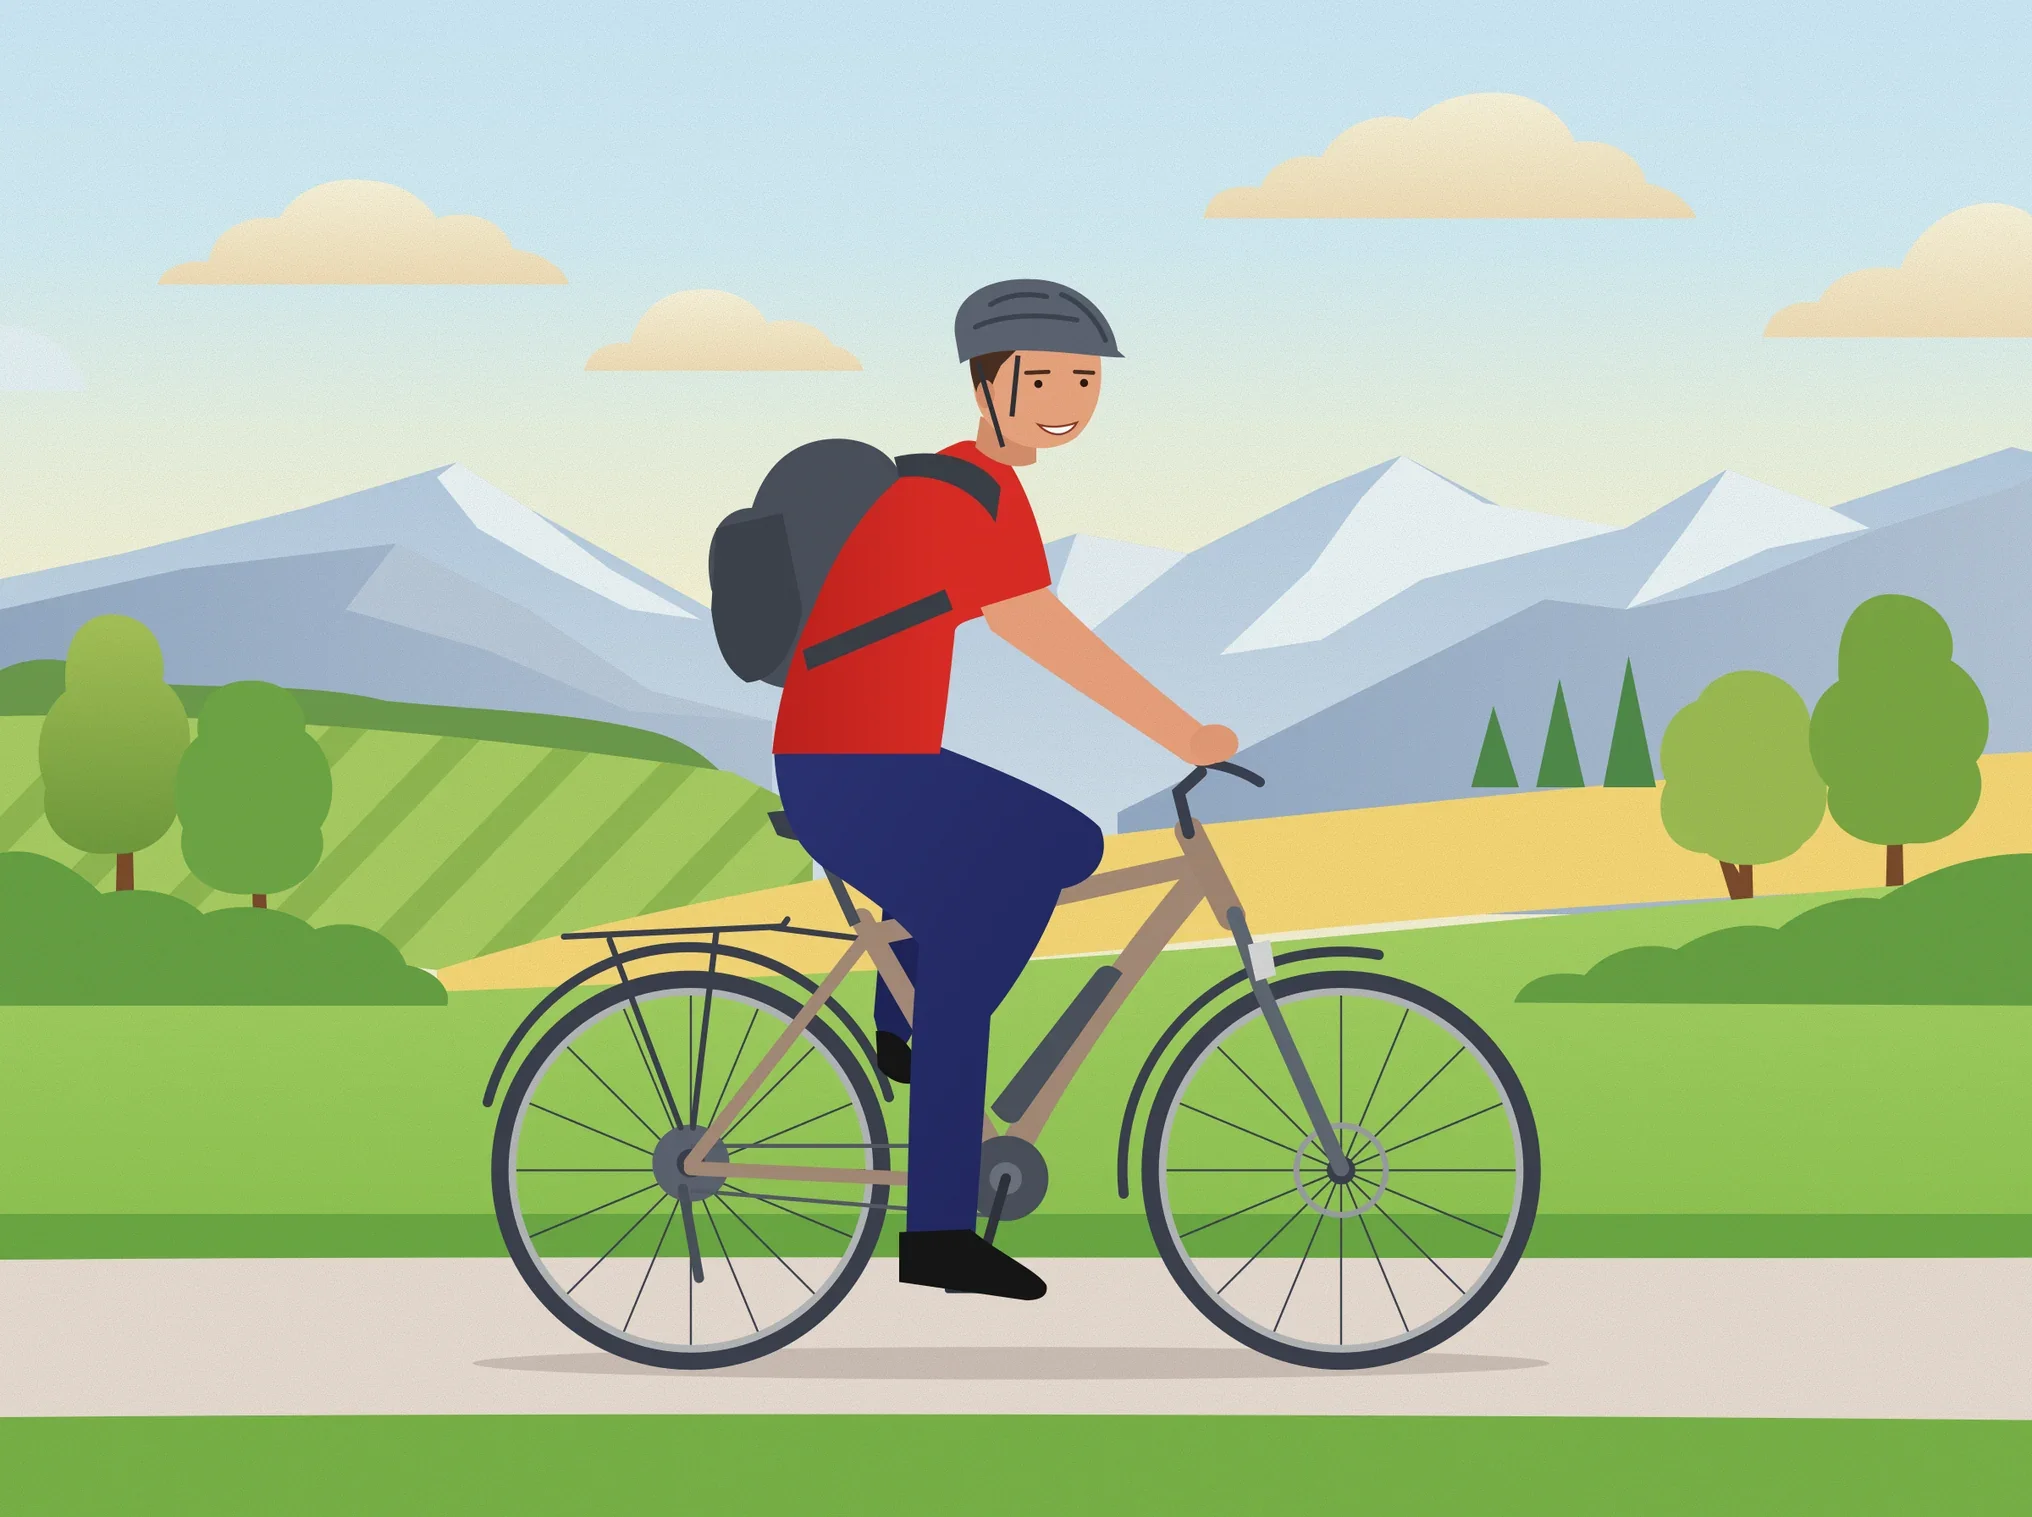
#17 Claude Opus 5.5 · medium
33.1 Score $0.39 3.5 min échoué Single-shot
-
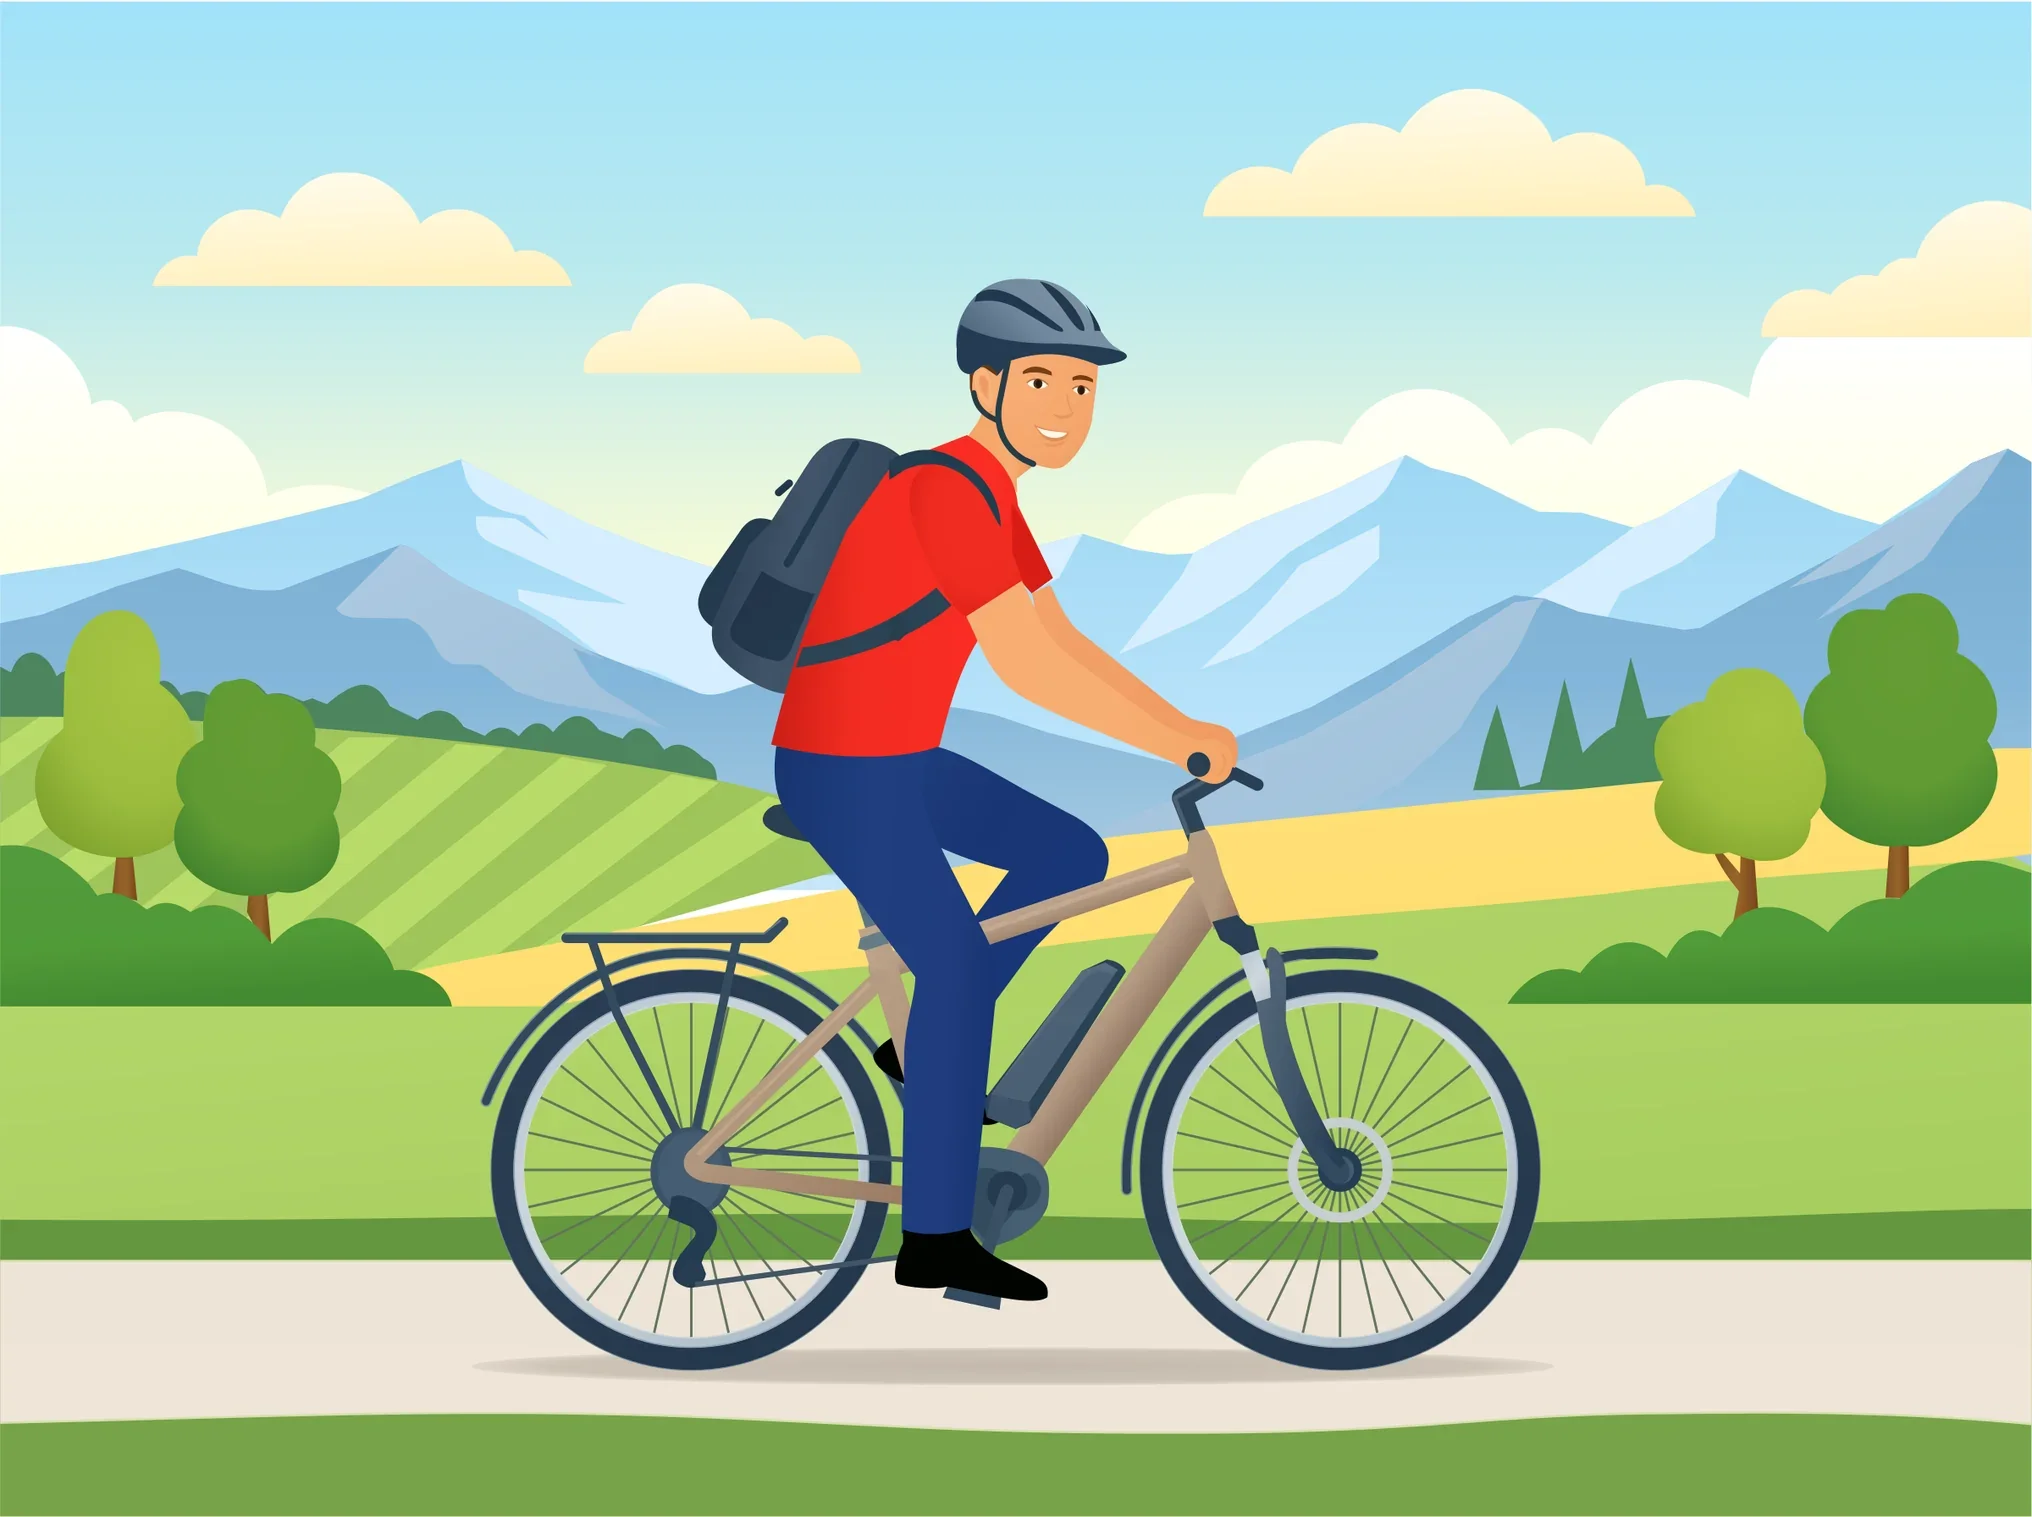
#18 Arrow 2 Telos, Extra High
39.6 Score ≥ $0.46 non chronométré échoué Outil
-
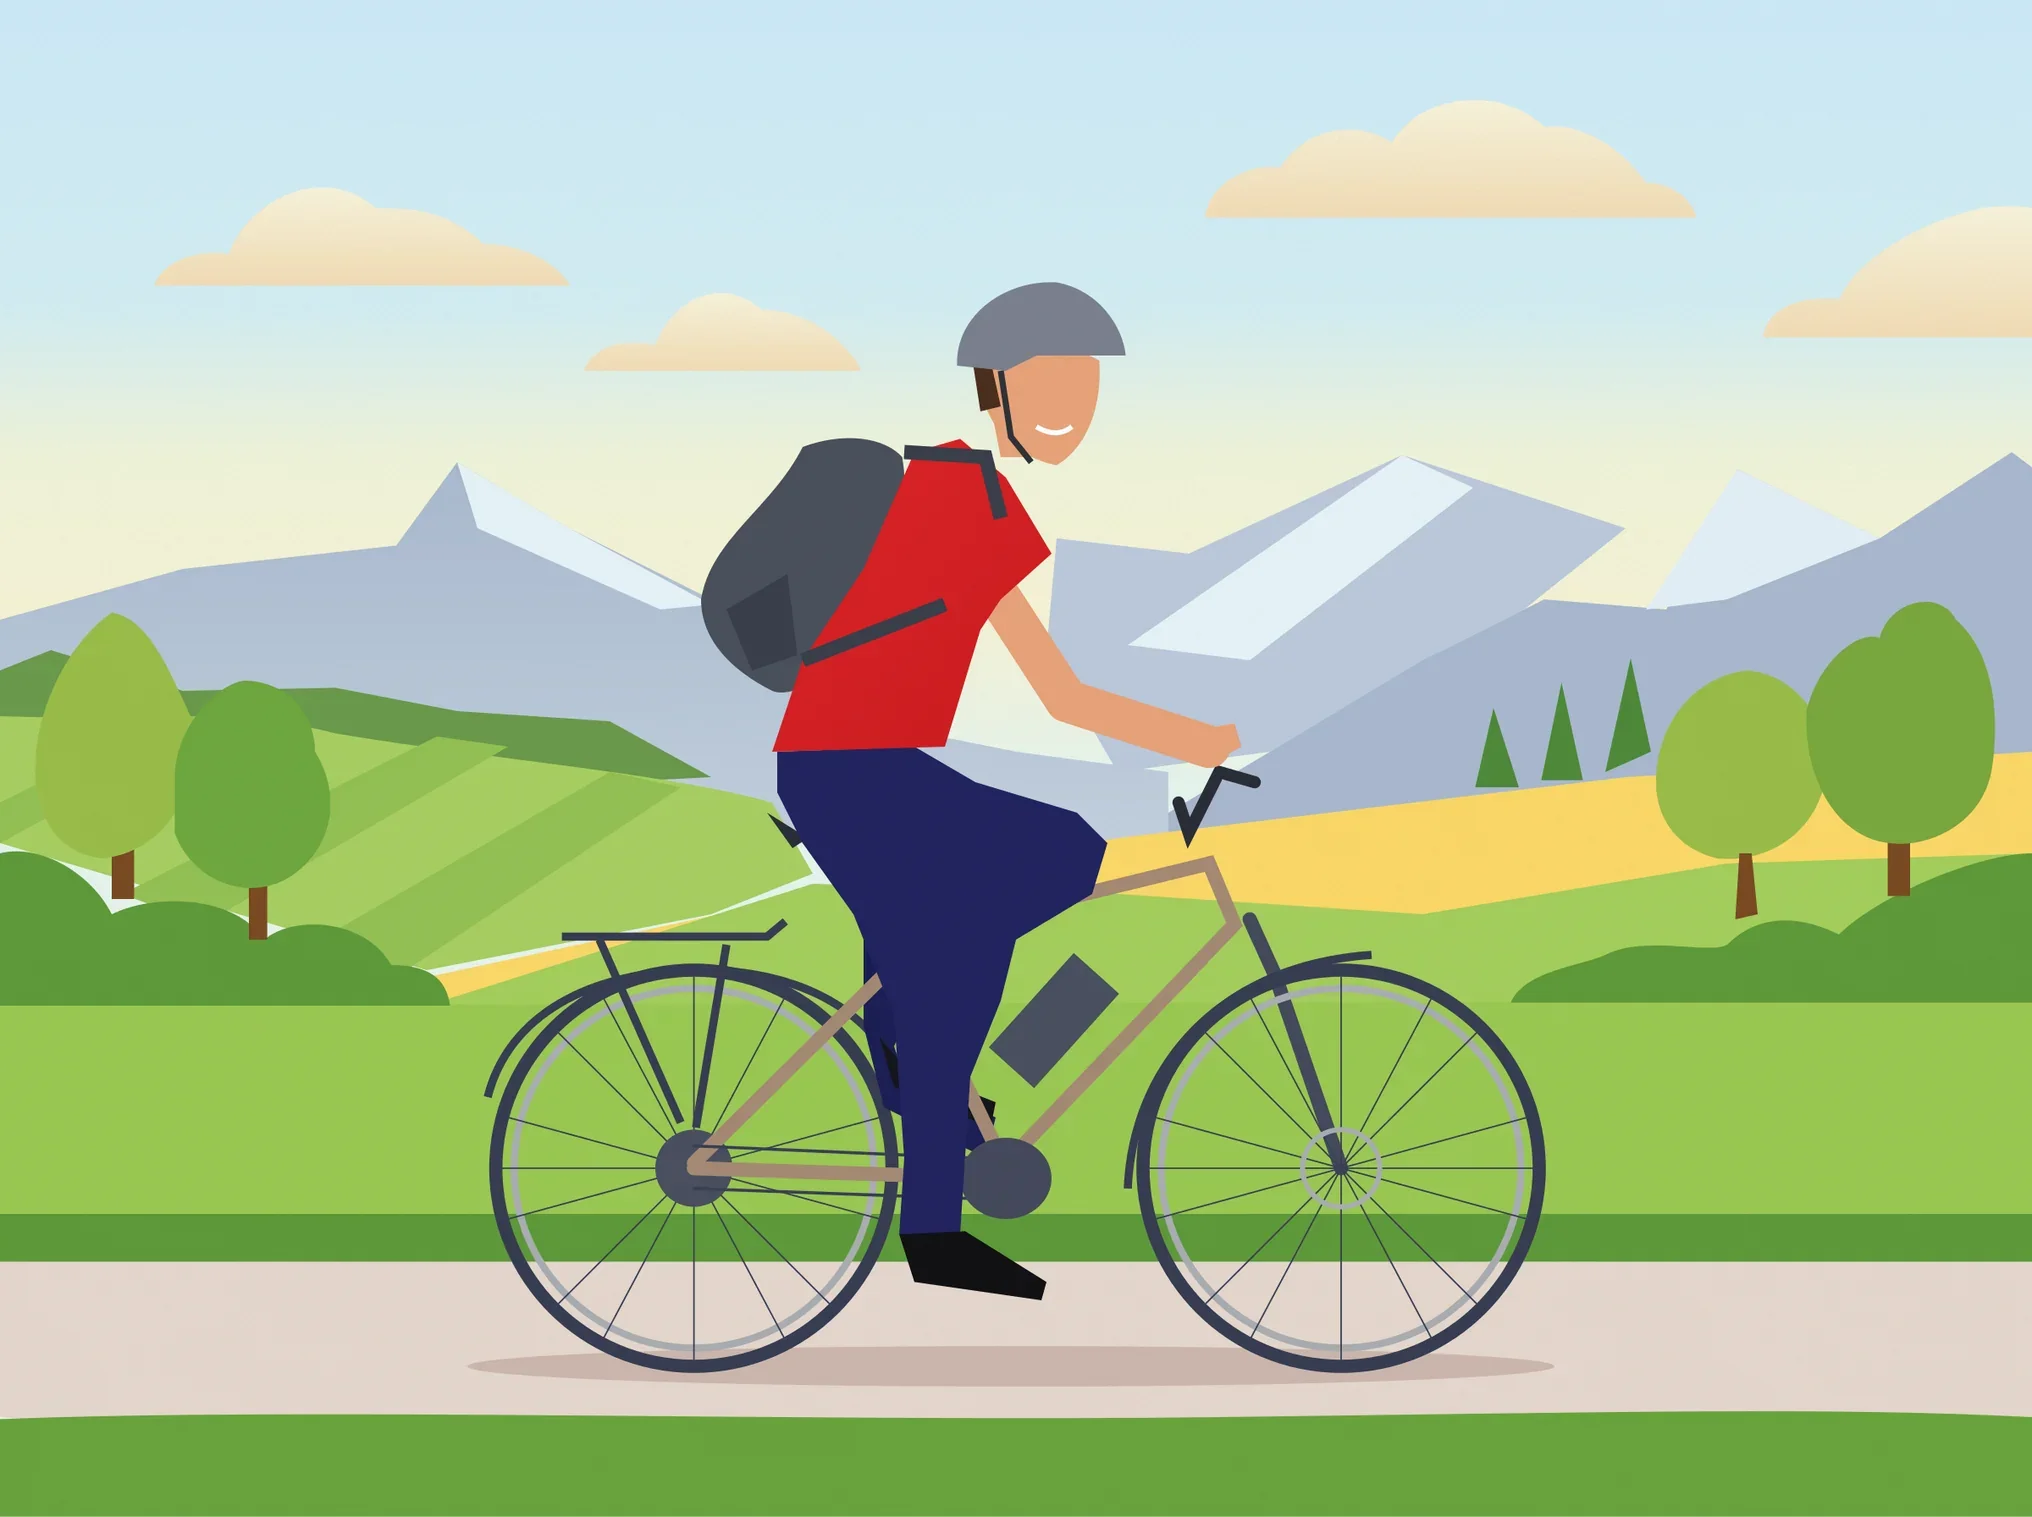
#19 Claude Sonnet 5.5 · medium
34.7 Score $0.52 5.2 min échoué Boucle fixe
-
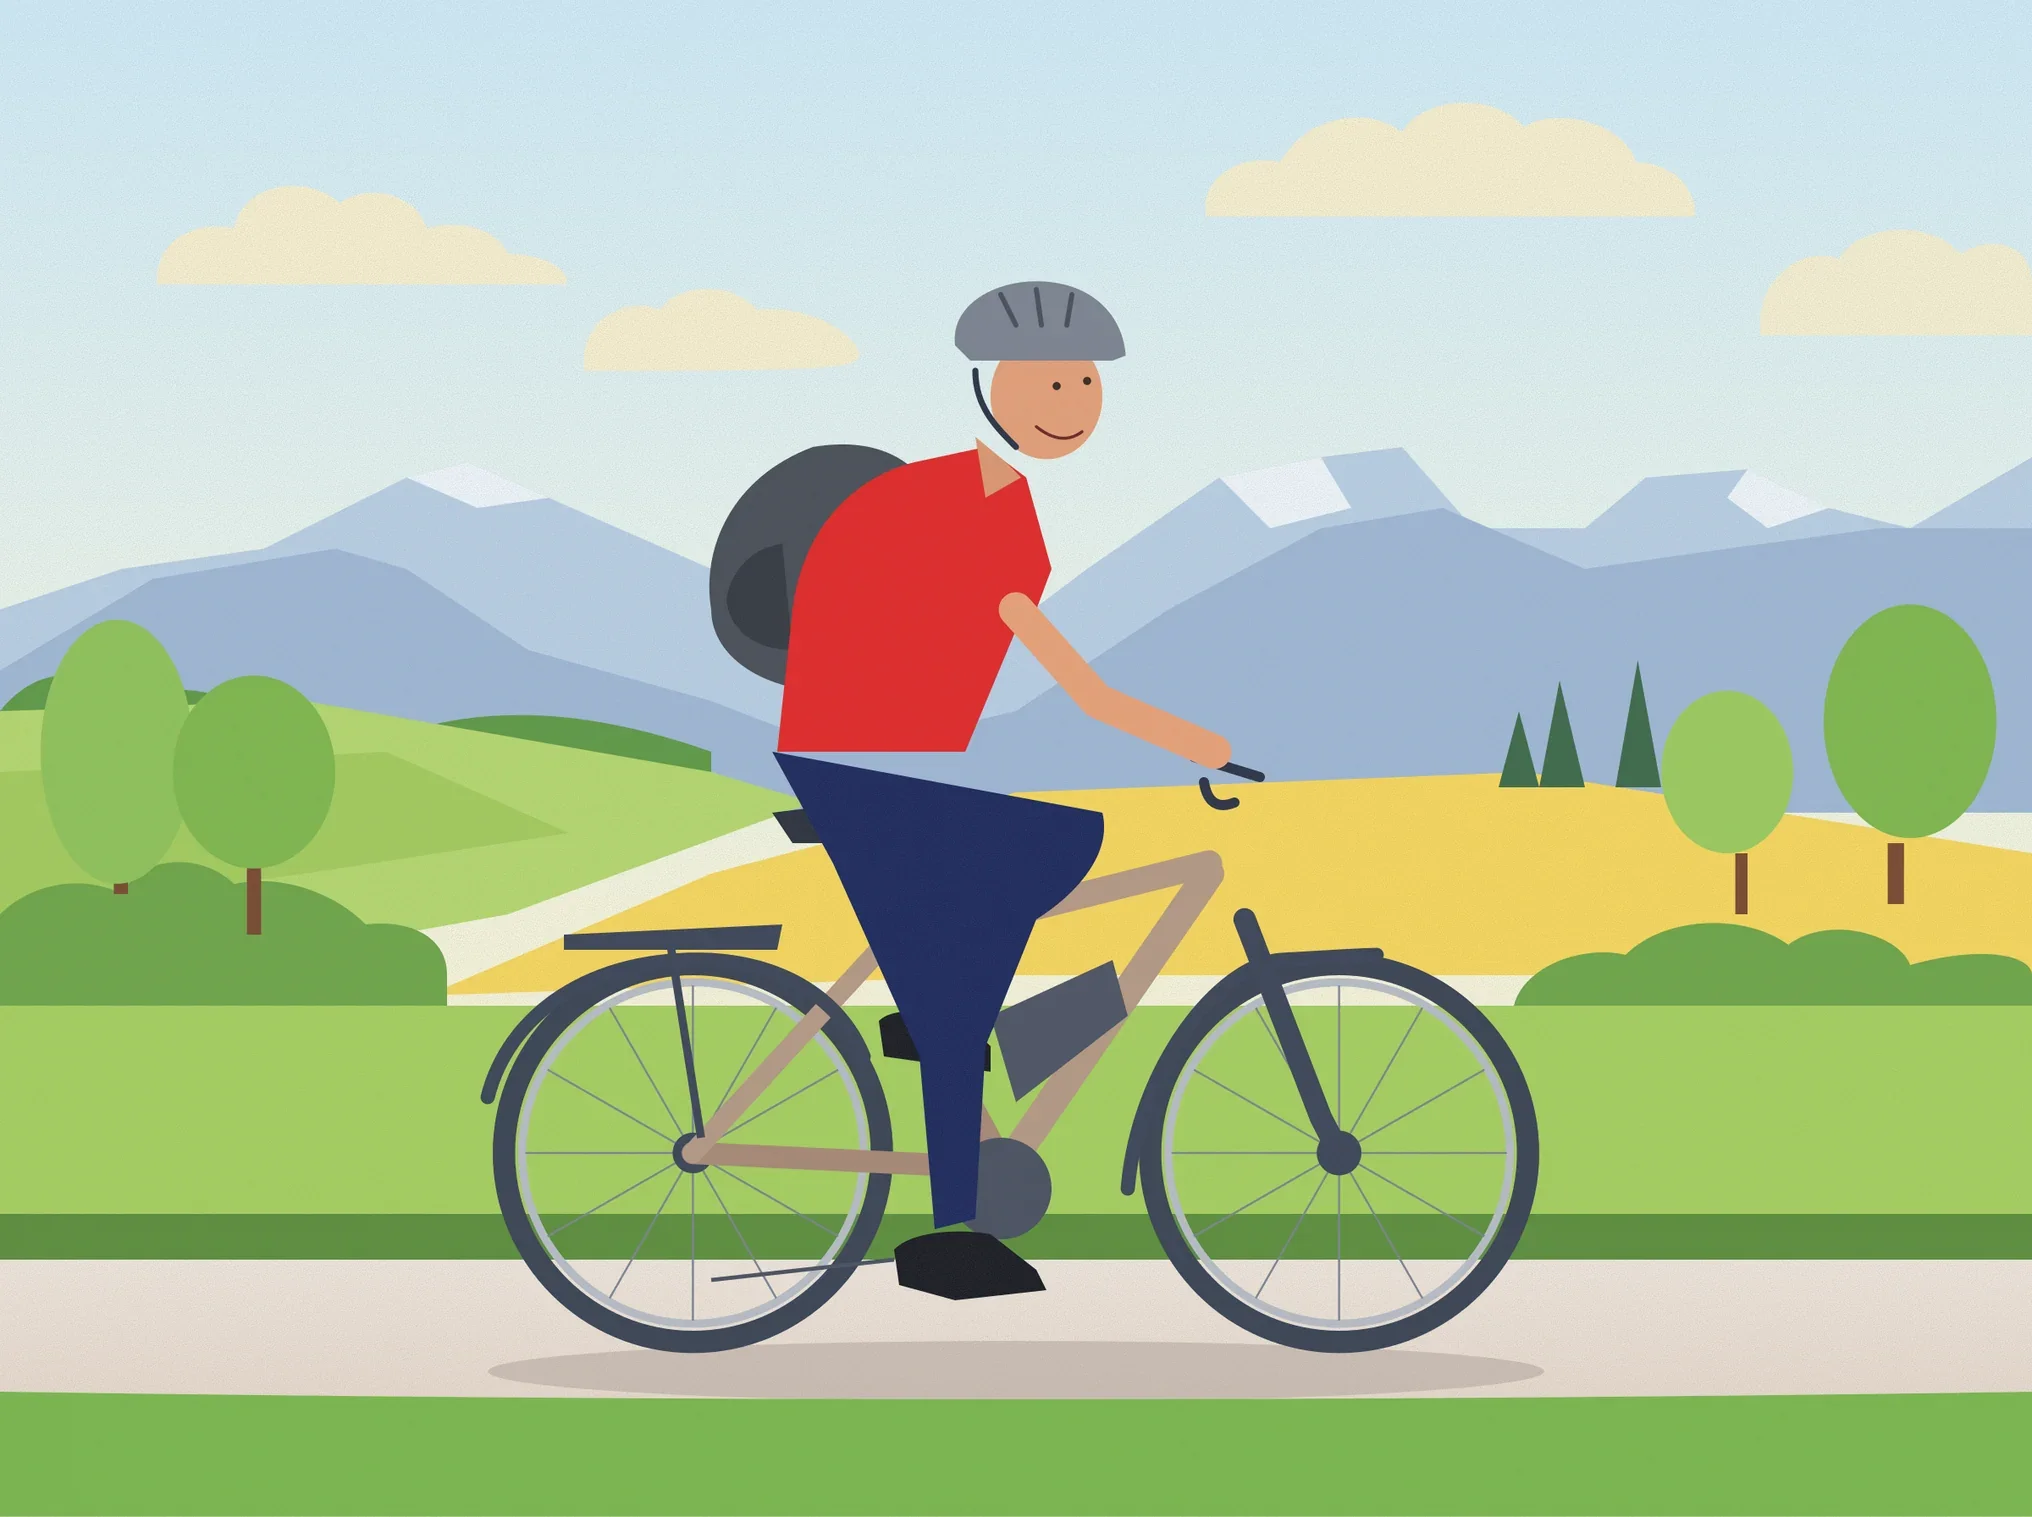
#20 Claude Haiku 5.5 · medium
30.5 Score $0.01 1.4 min échoué Single-shot
-
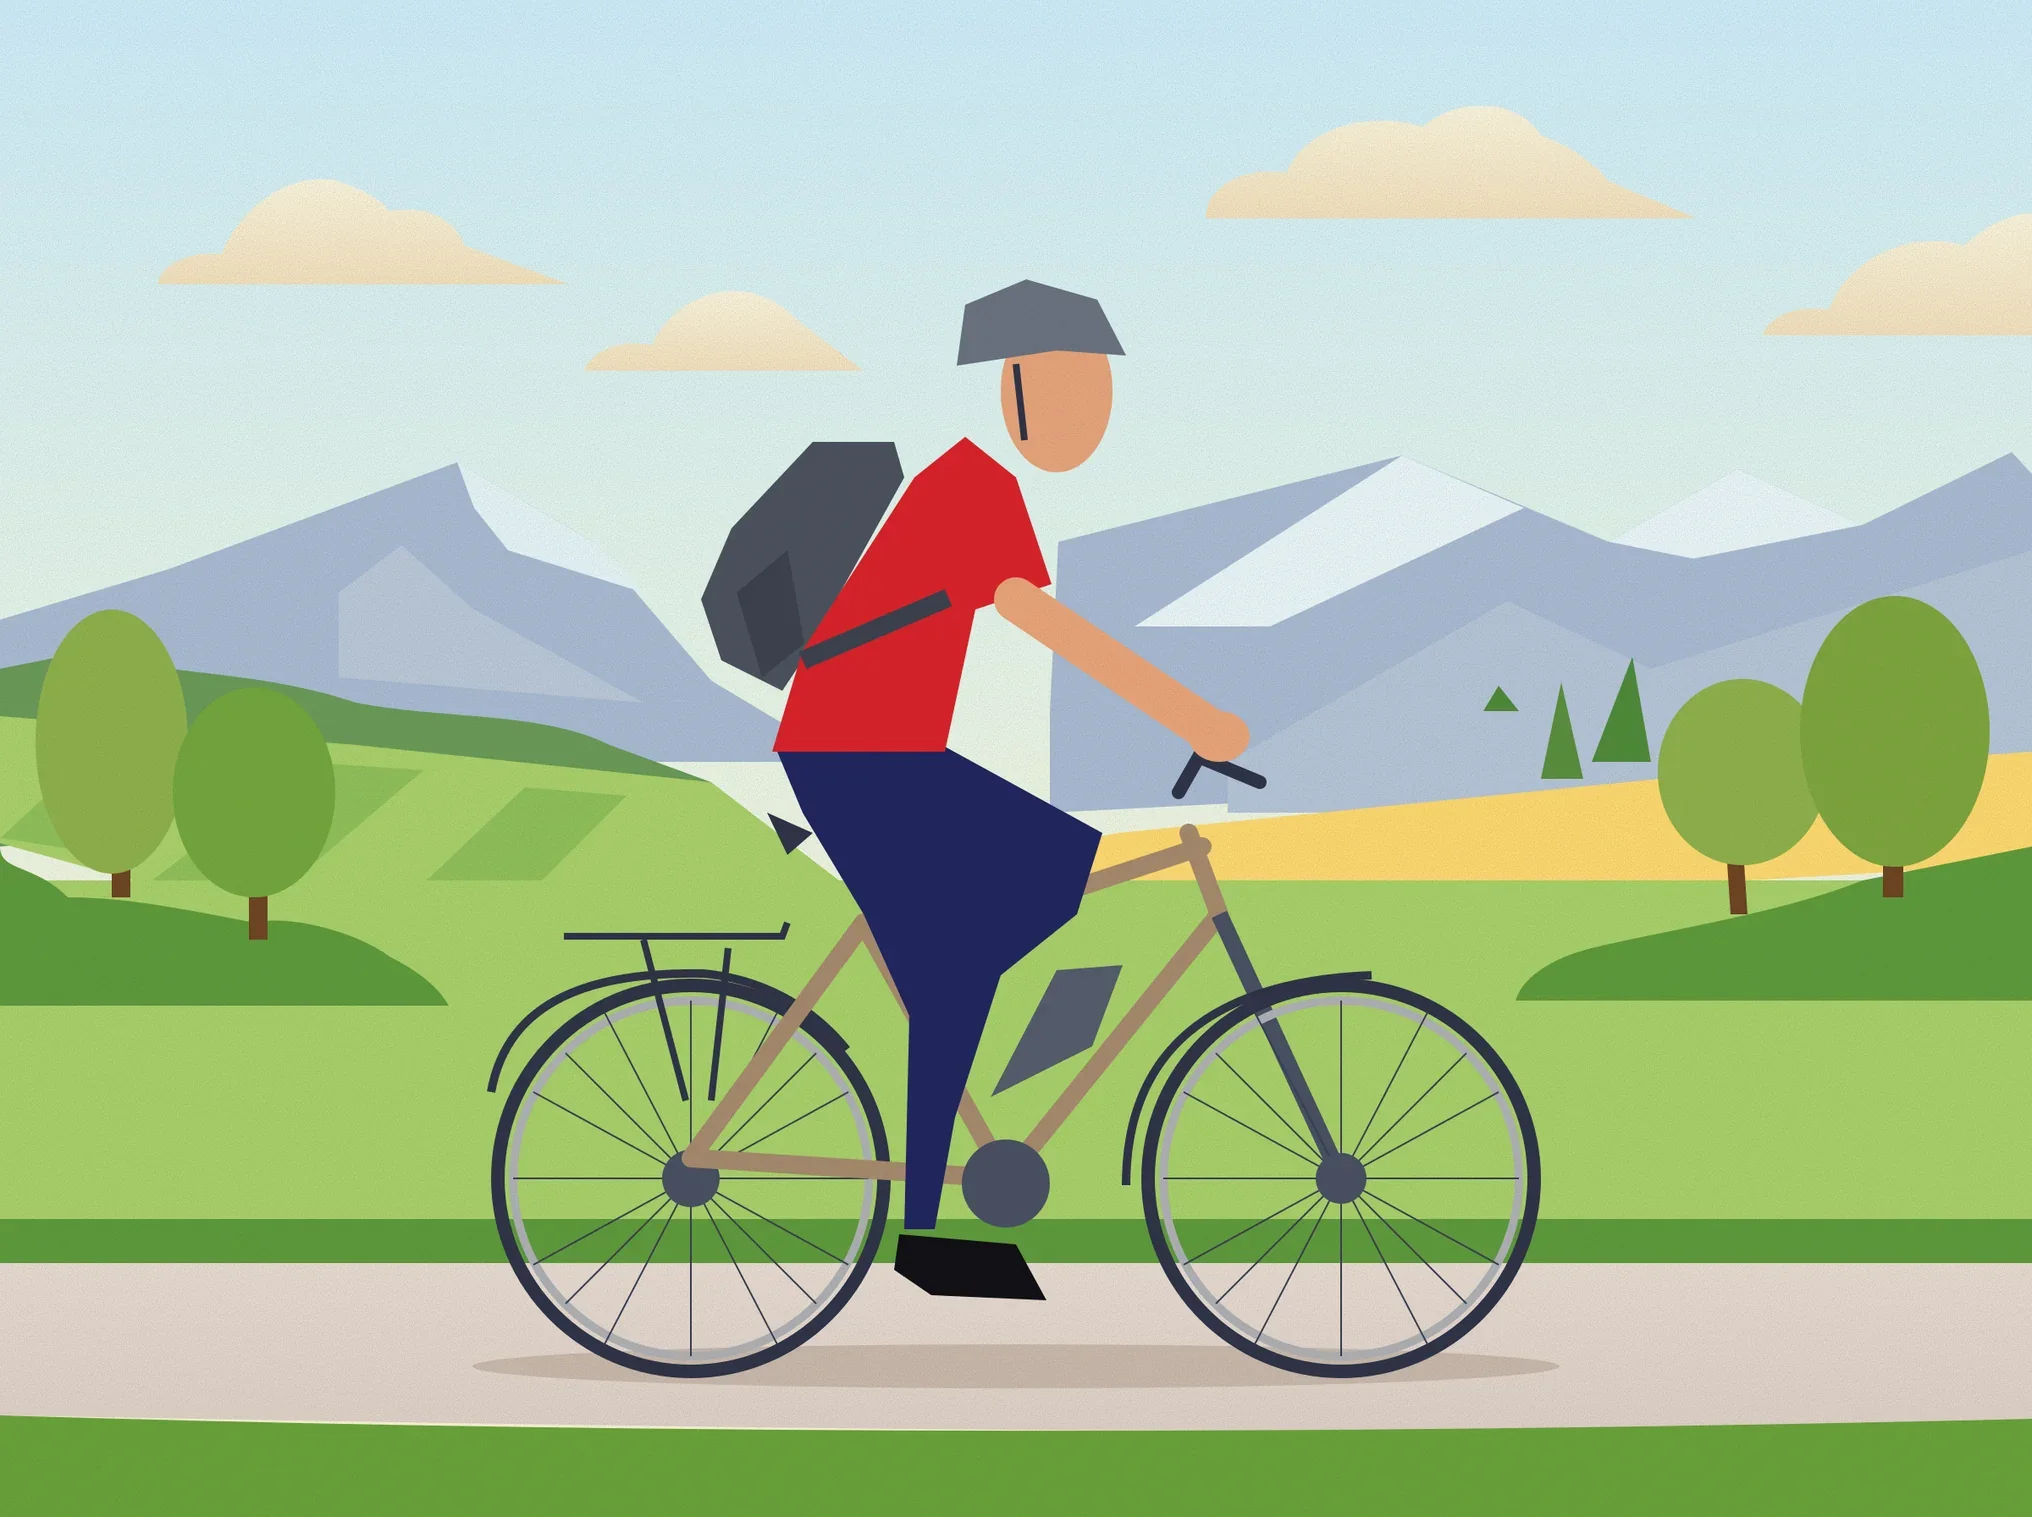
#21 Claude Sonnet 5.5 · medium
30.1 Score $0.11 1.8 min échoué Single-shot
-
#22 Arrow 2, Extra High
17.4 Score ≥ $0.28 non chronométré échoué Outil
L'original contre Claude Opus 5.5 · max
Original Claude Opus 5.5 · max Zooms
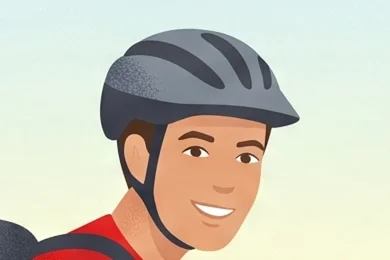
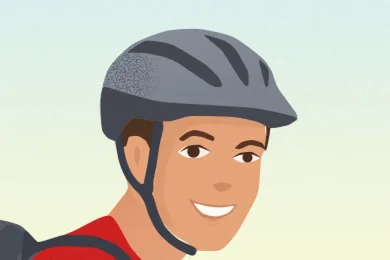
Visage et casque
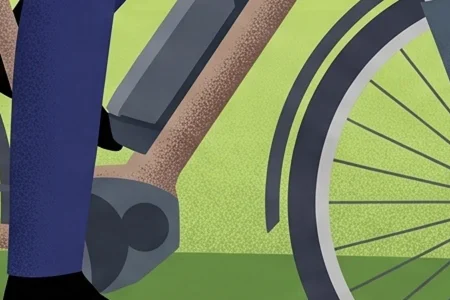
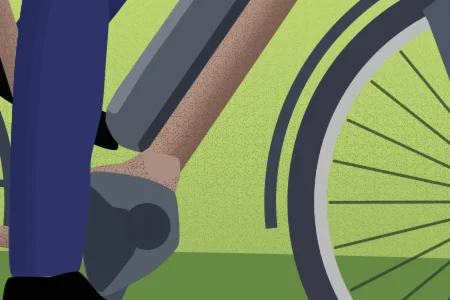
Transmission
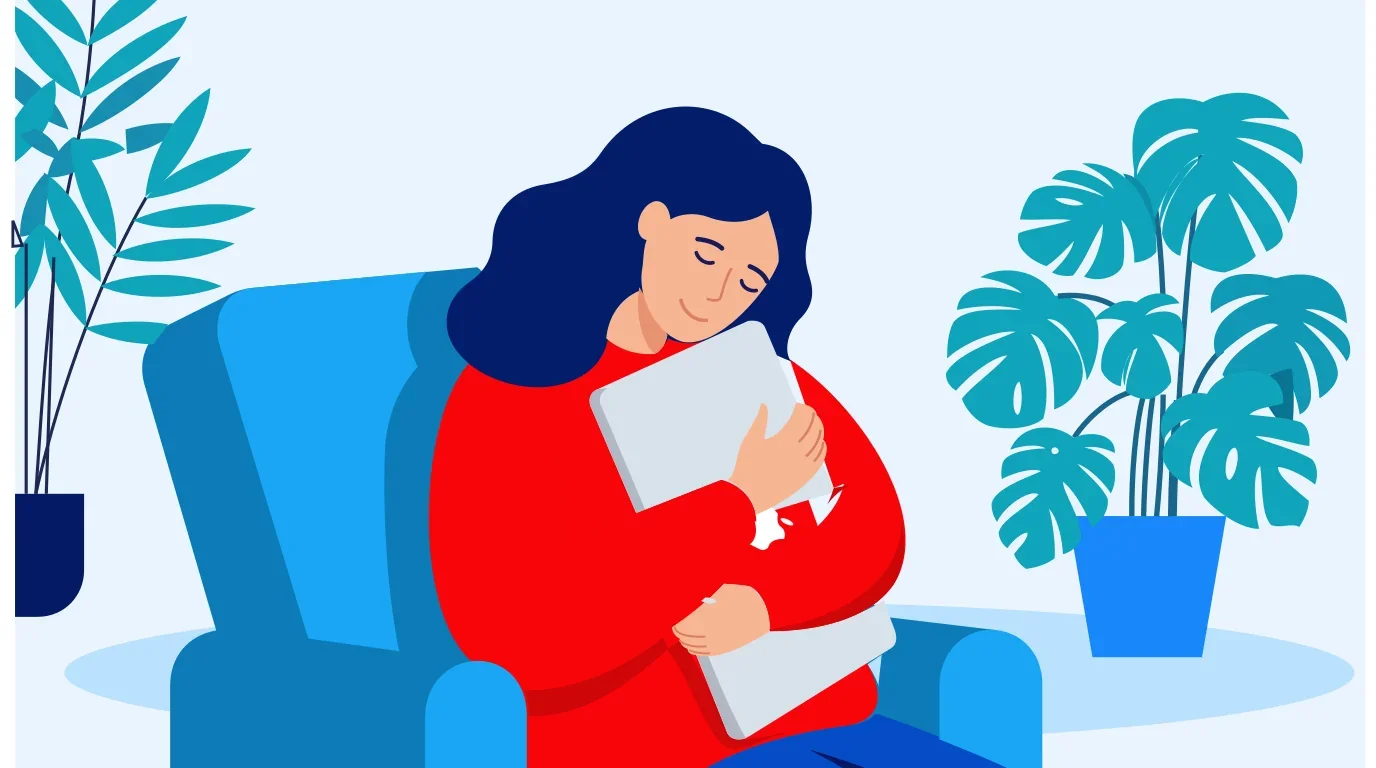
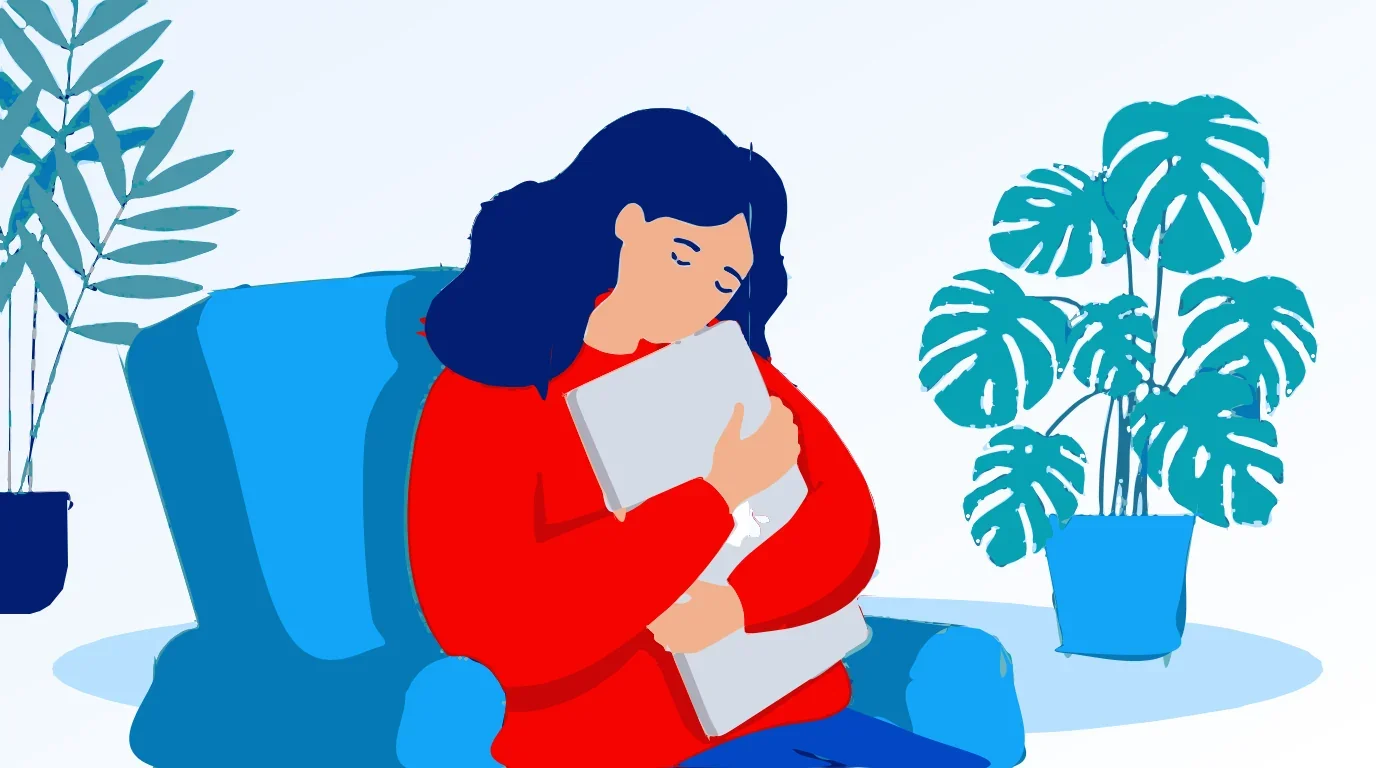
Résultats : L'étreinte de l'ordinateur
-
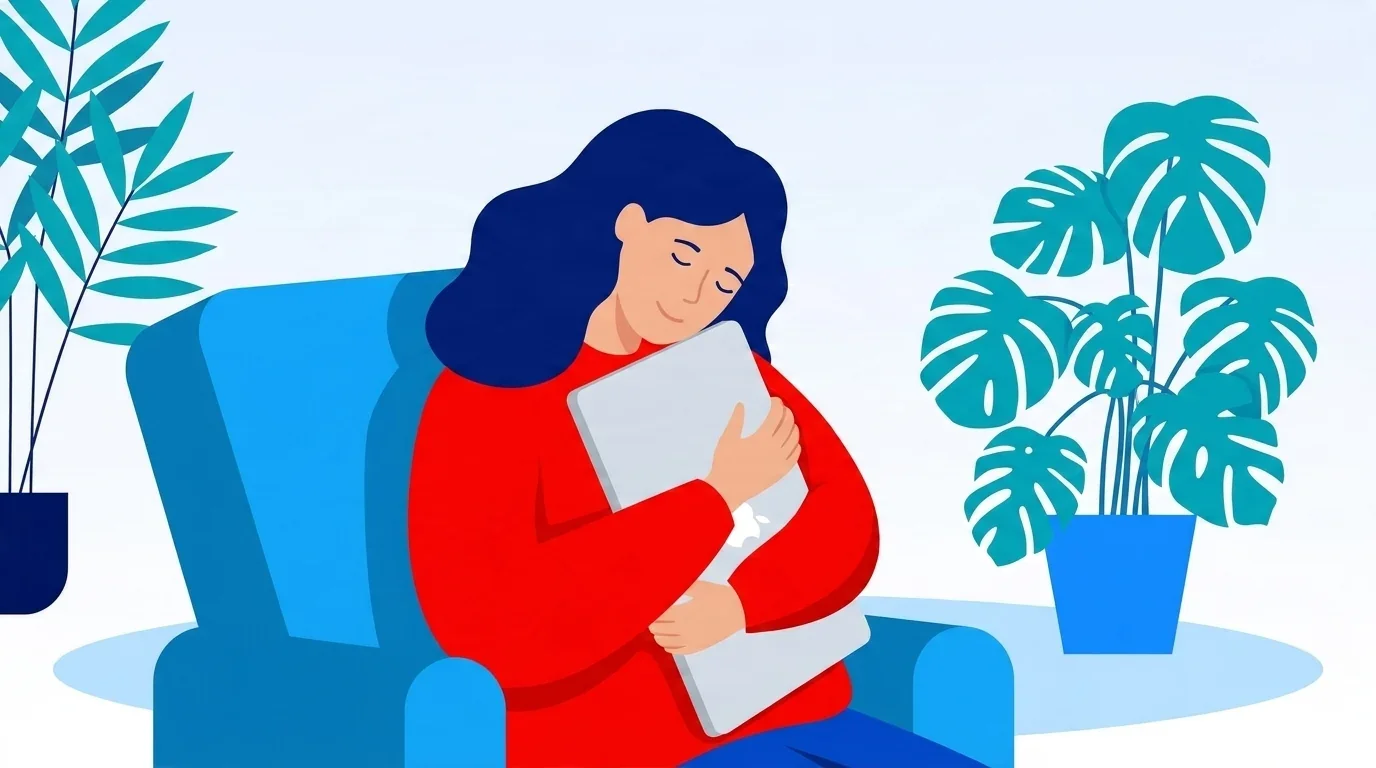
Original
1376 × 768 px
-
#1 Claude Opus 5.5 · max
87.5 Score $43.5 108 min passé Agentique
-
#2 Claude Sonnet 5.5 · xhigh
84.3 Score $23.4 84 min passé Agentique
-
#3 Claude Opus 5.5 · xhigh
83.7 Score $27.1 83 min passé Agentique
-
#4 Claude Opus 5.5 · high
84.7 Score $19.5 72 min passé Agentique
-
#5 GPT 6.1 Sol · xhigh
75.7 Score $6.8 57 min passé Agentique
-
#6 GPT 6.1 Sol · high
74.4 Score $5.3 48 min passé Agentique
-
#7 Claude Sonnet 5.5 · high
75.2 Score $8.5 31 min passé Agentique
-
#8 Claude Fable 5.1 · xhigh
63.1 Score $42.9 88 min échoué Agentique
-
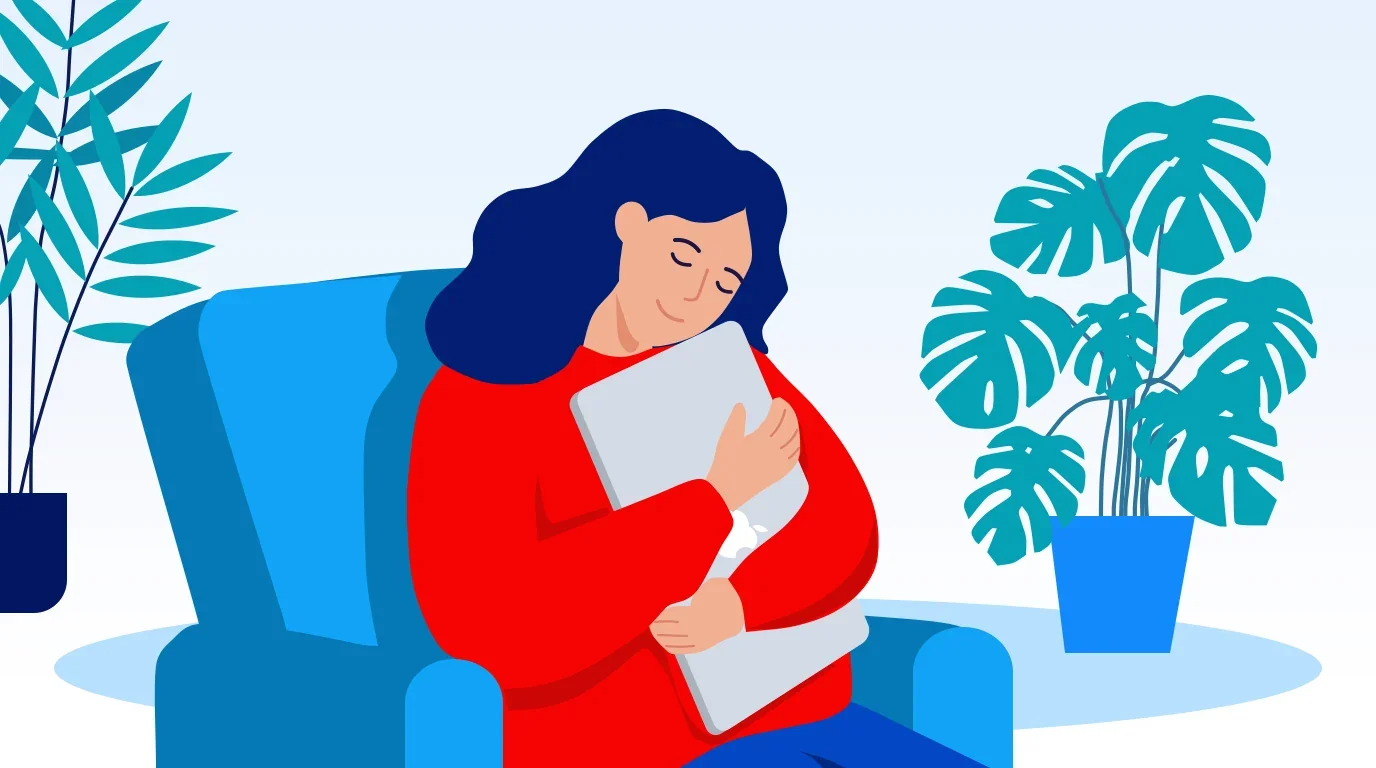
#9 Claude Opus 5.5 · medium
77.5 Score $9.8 33 min passé Agentique
-
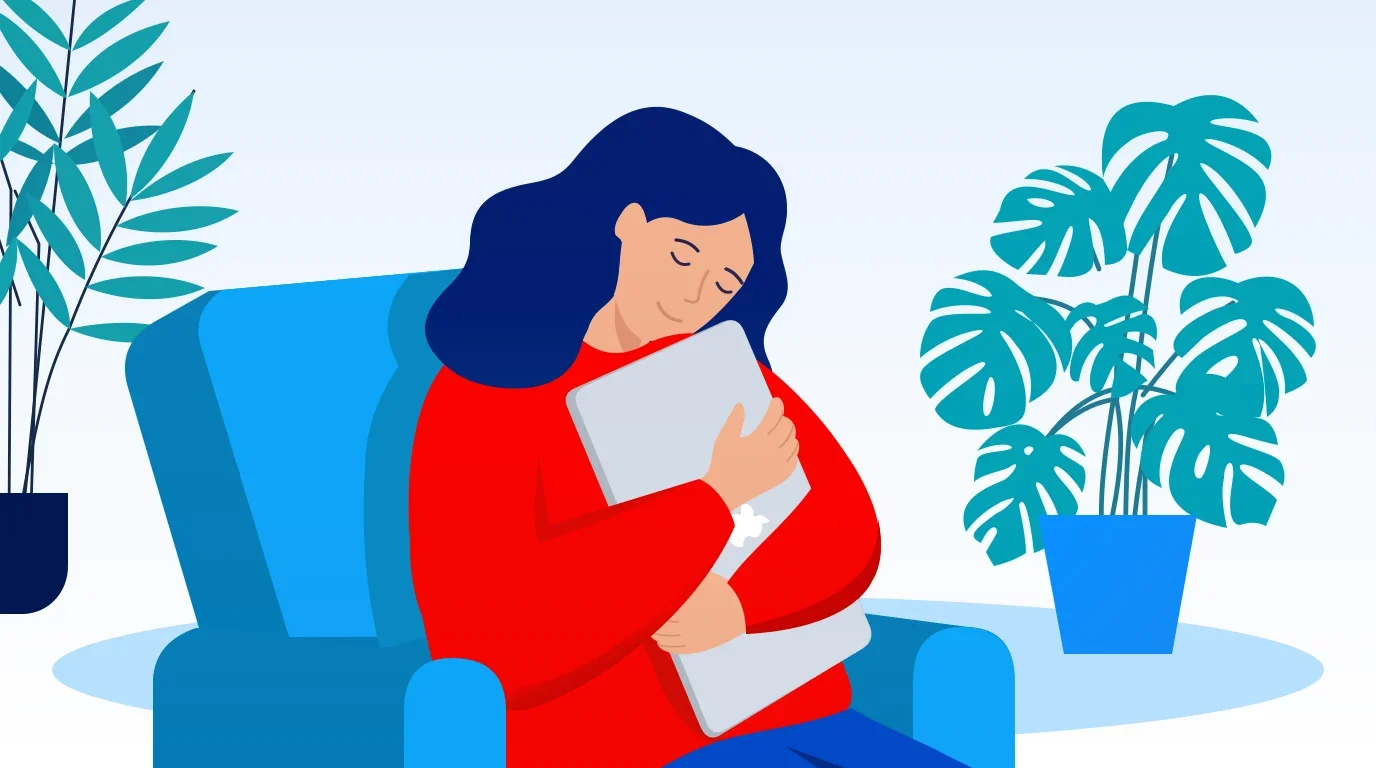
#10 GPT 6.1 Sol · medium
64.6 Score $2.3 18 min échoué Agentique
-
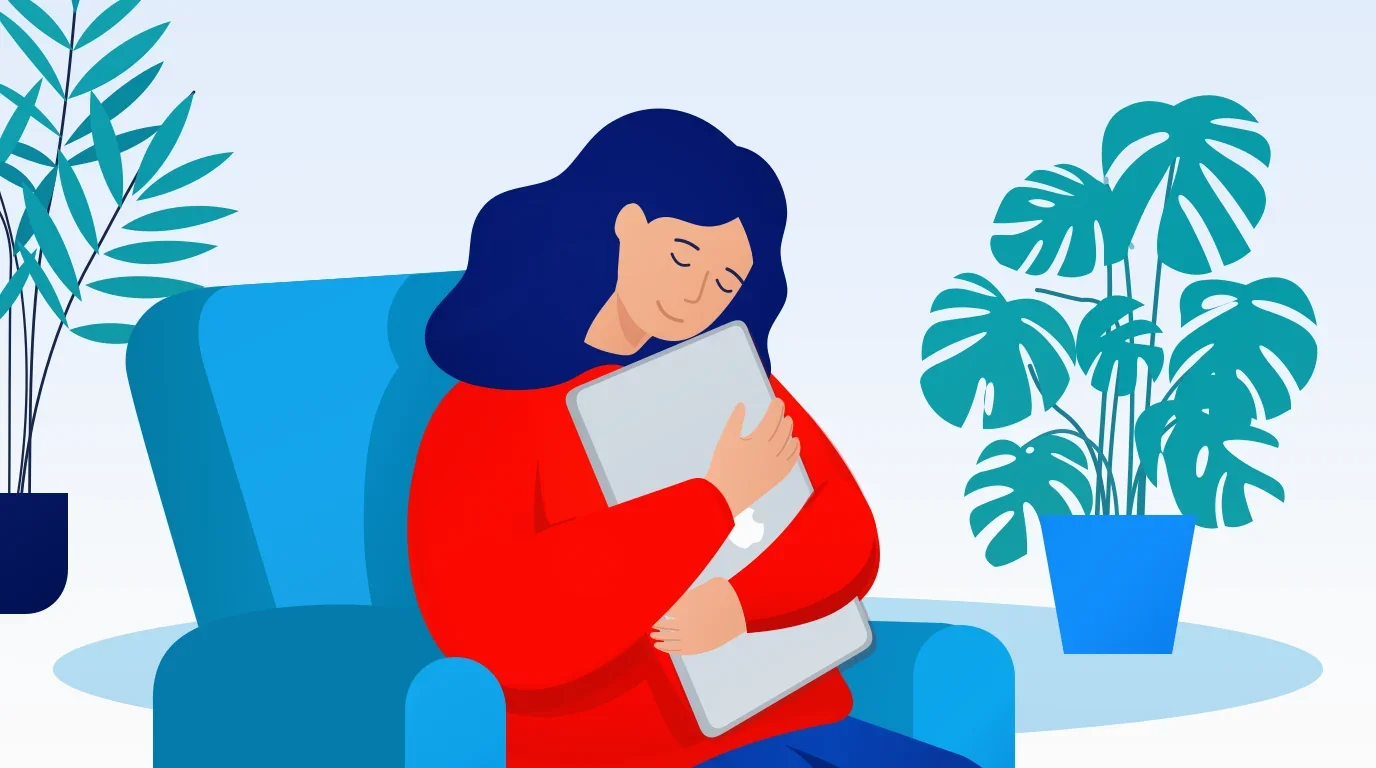
#11 GPT 6.1 Sol · xhigh
49.6 Score $0.31 11 min échoué Single-shot
-
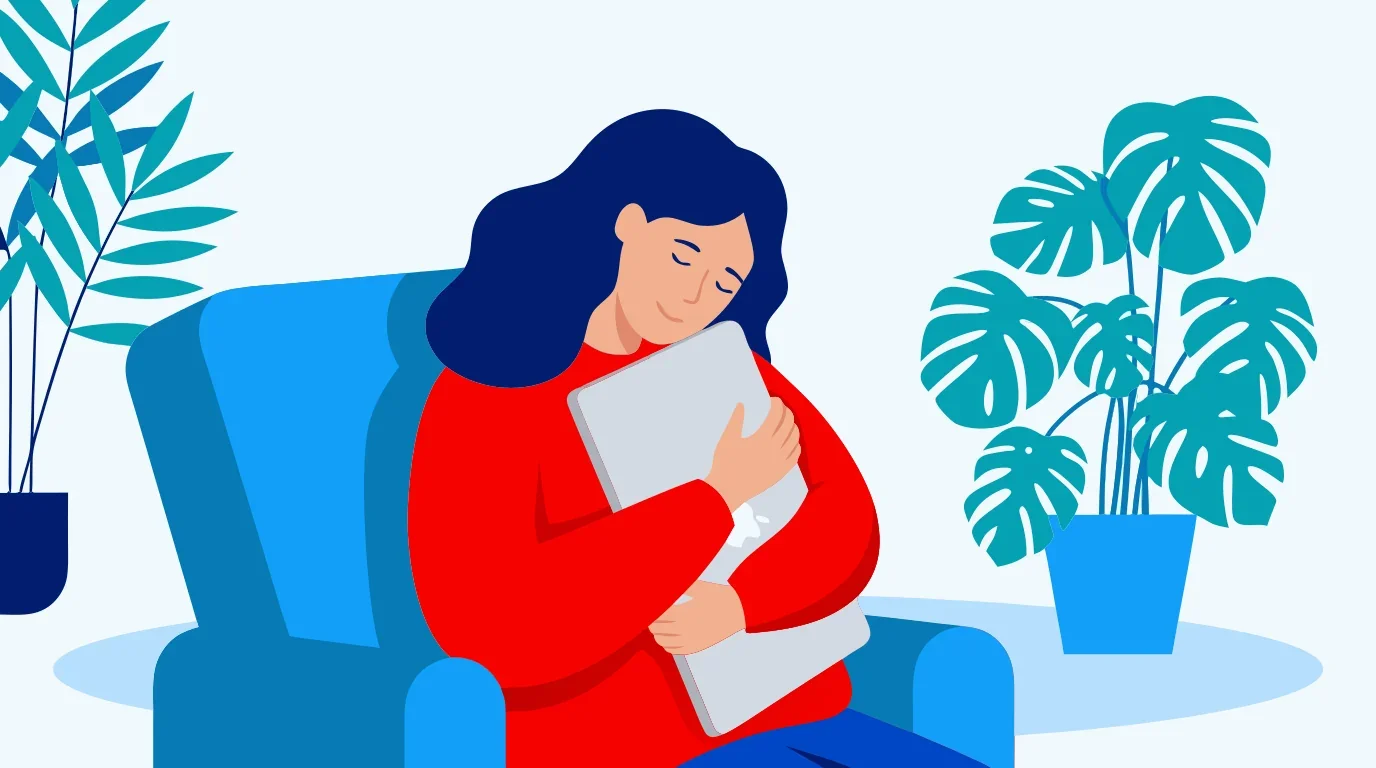
#12 Recraft Vectorize
53.2 Score $0.01 non chronométré passé Outil
-
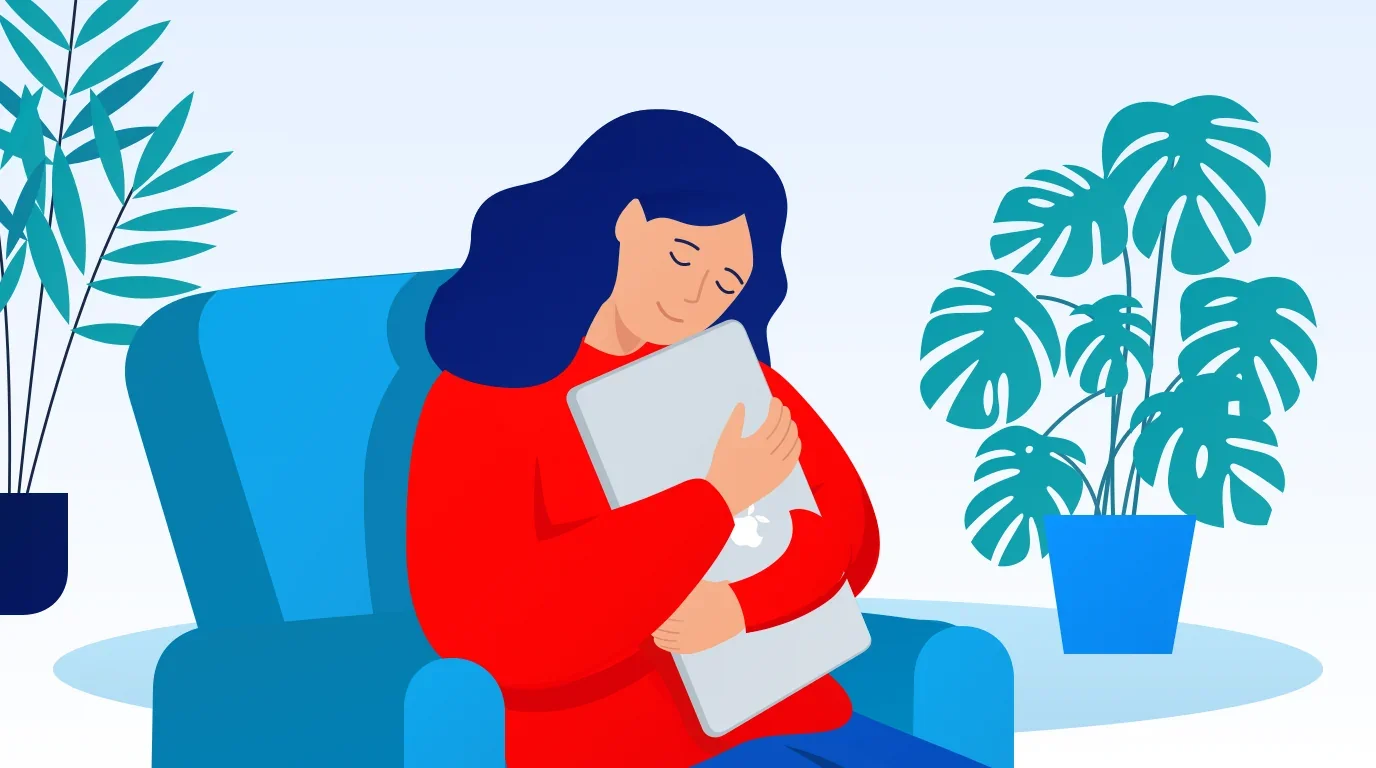
#13 GPT 6.1 Sol · medium
49.2 Score $0.13 4 min échoué Single-shot
-
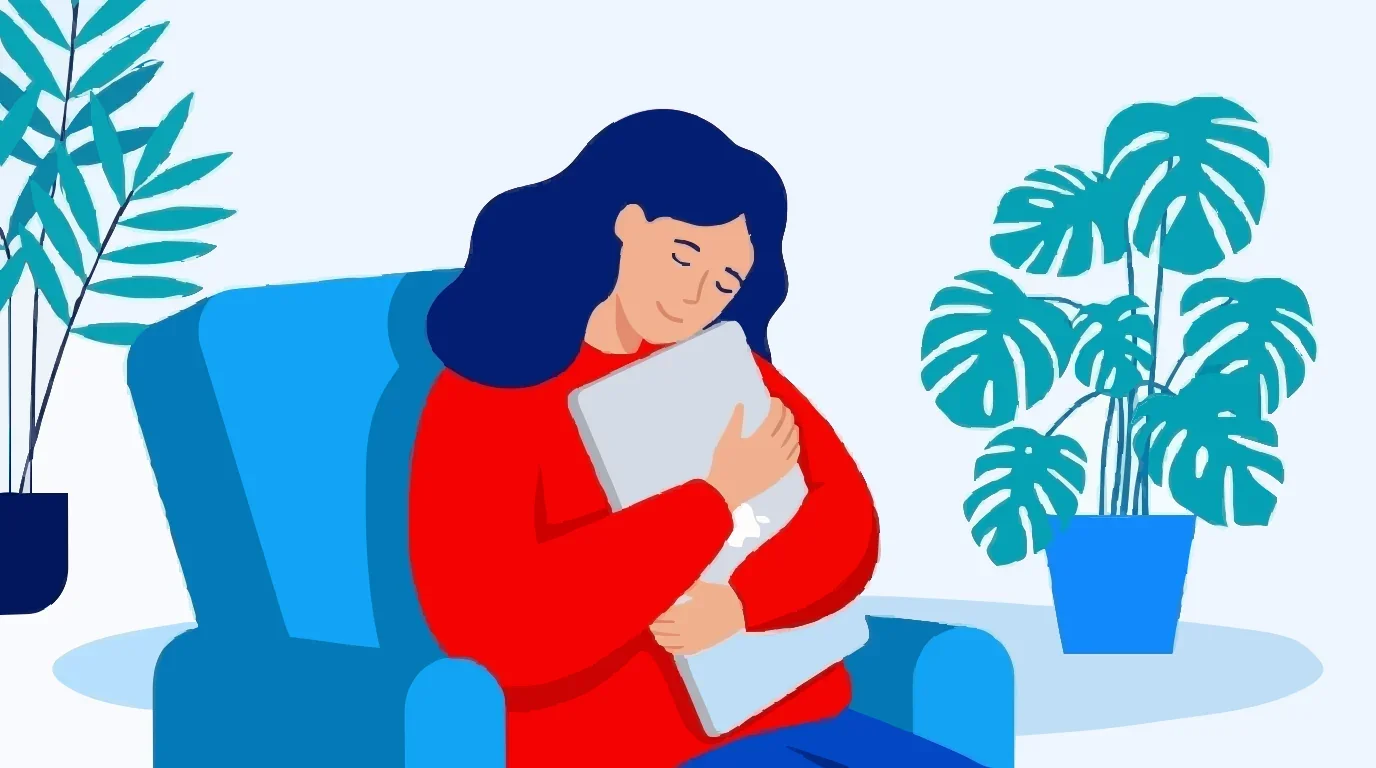
#14 vtracer 0.6.15, default settings
50.2 Score $0.00 0 min passé Outil
-
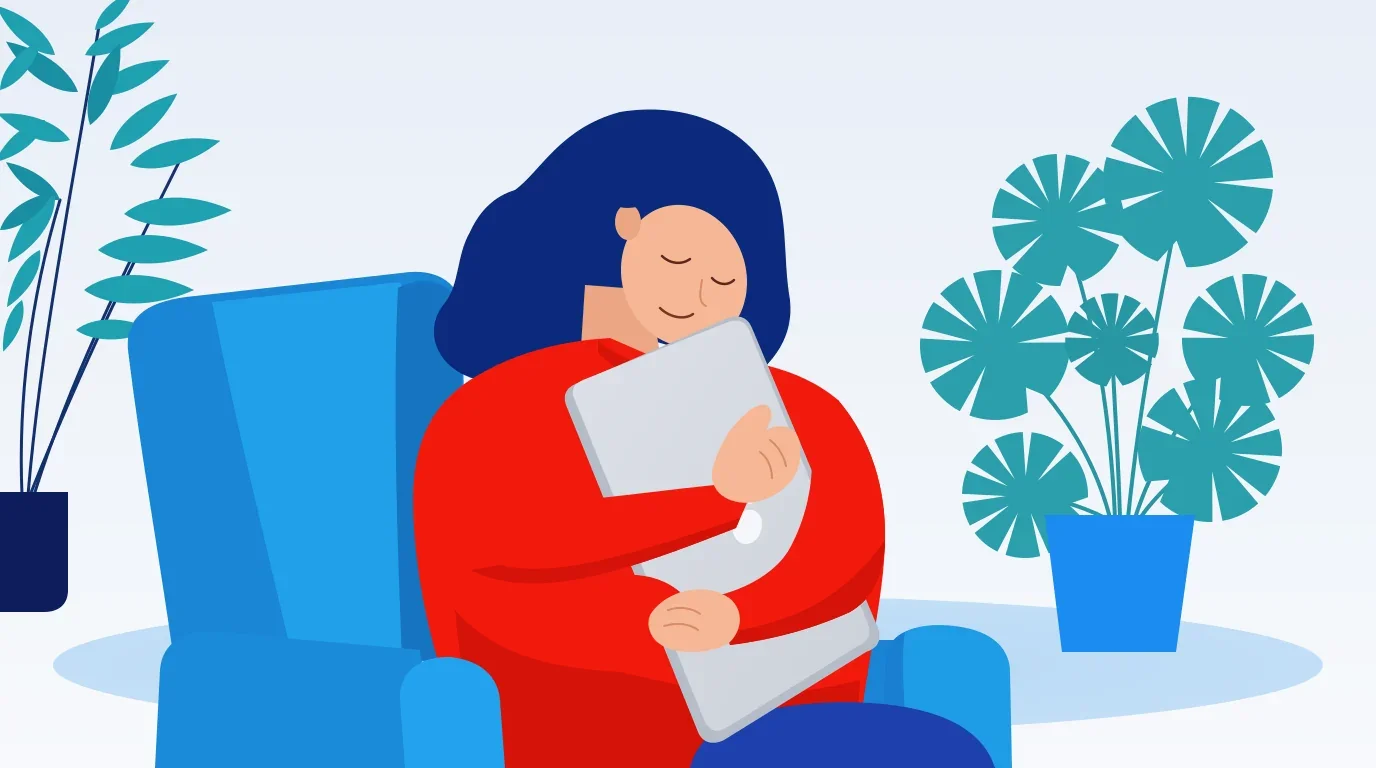
#15 Claude Opus 5.5 · medium
36.5 Score $1.6 7.7 min échoué Boucle fixe
-
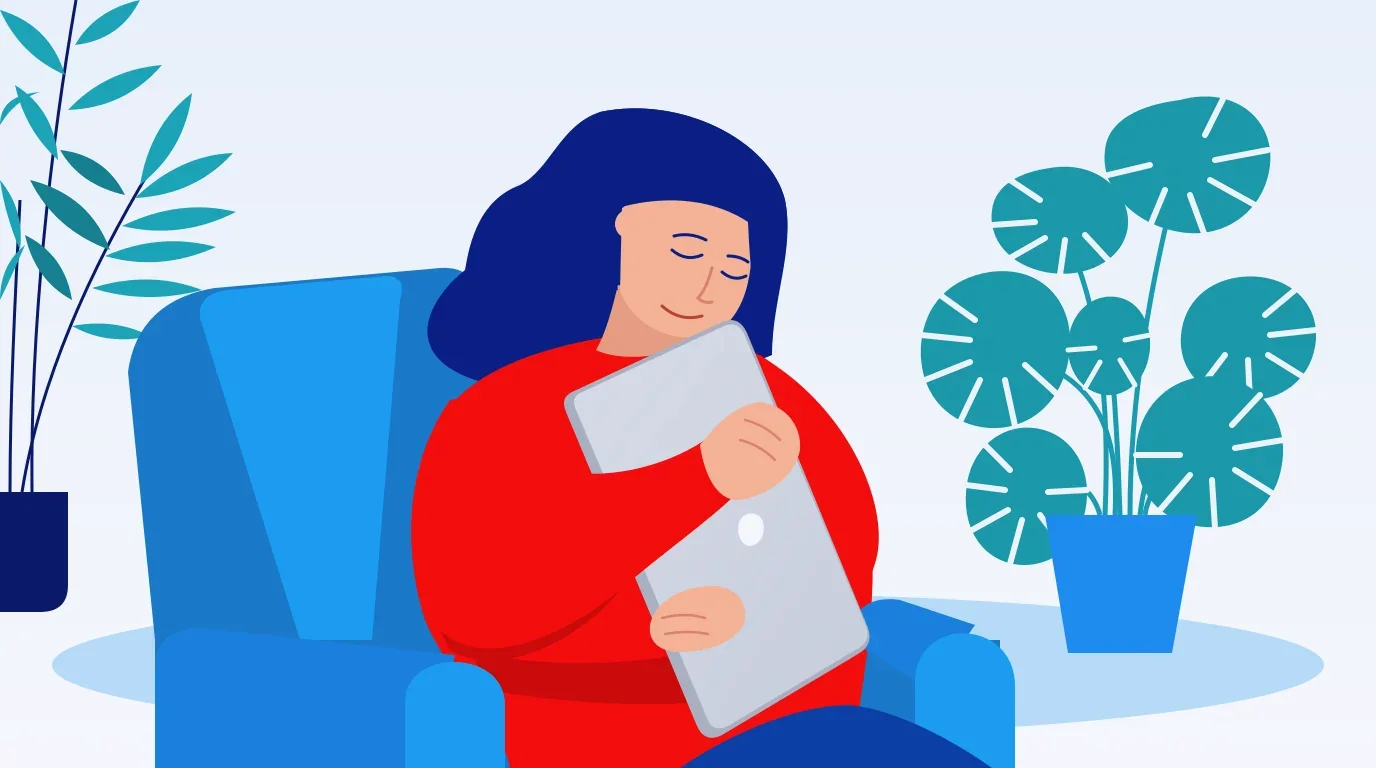
#16 Claude Fable 5.1 · medium
35.4 Score $0.68 2.5 min échoué Single-shot
-
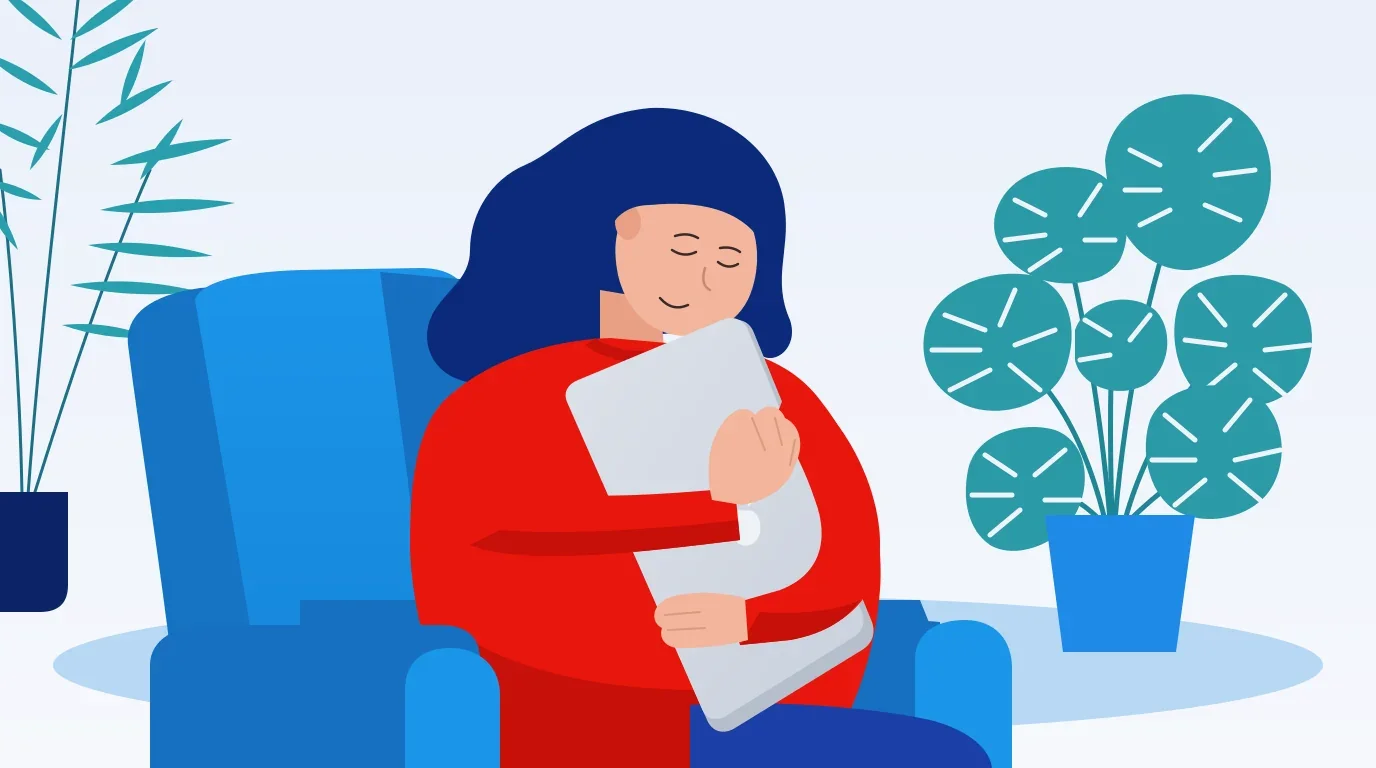
#17 Claude Opus 5.5 · medium
36.0 Score $0.26 2.2 min échoué Single-shot
-
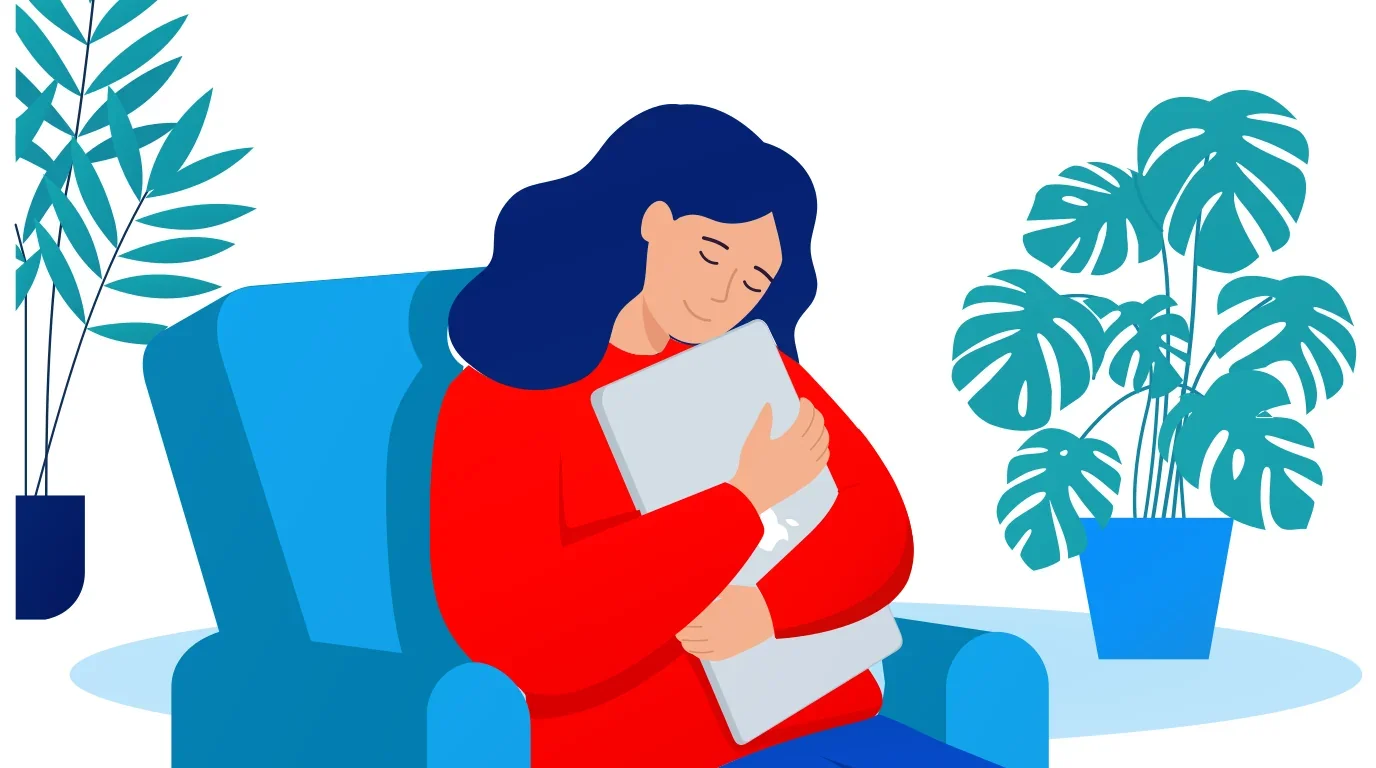
#18 Arrow 2 Telos, Extra High
29.0 Score ≥ $0.25 non chronométré échoué Outil
-
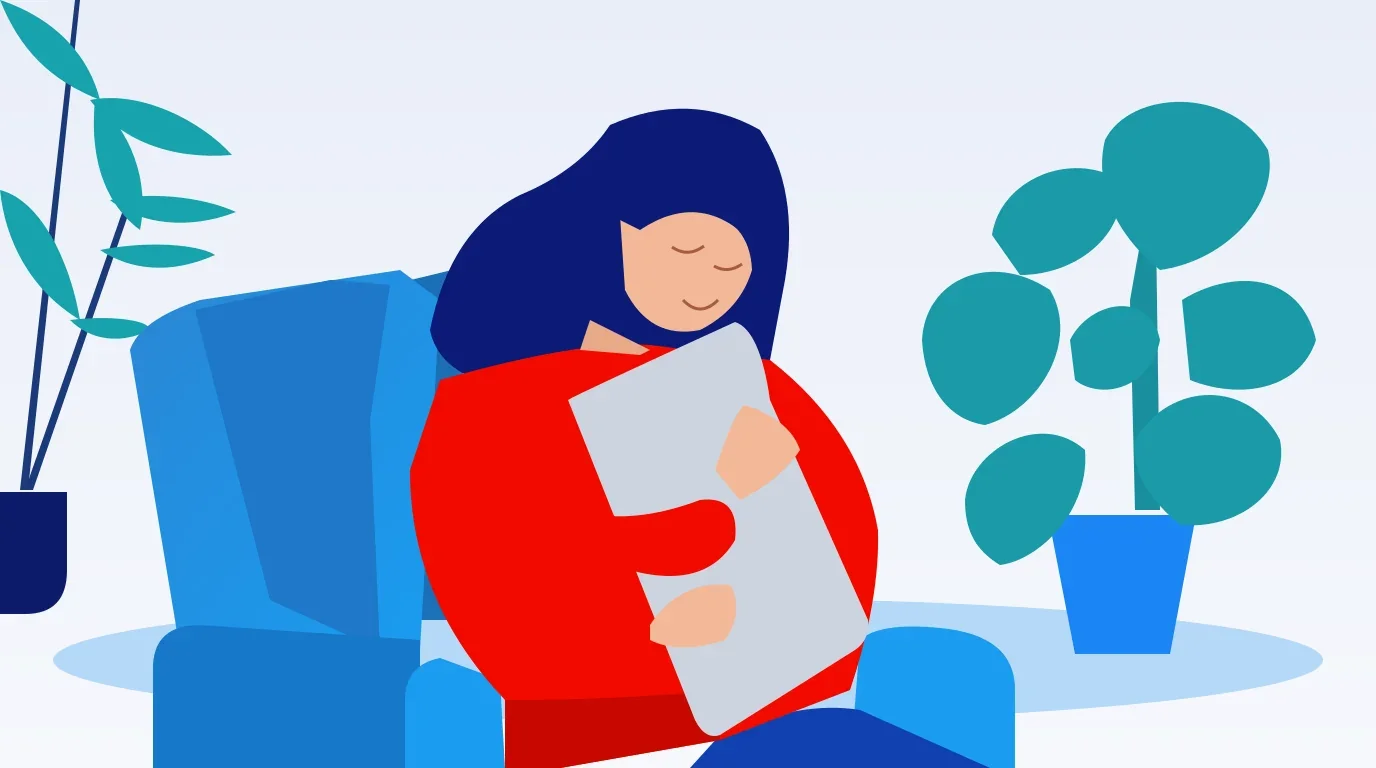
#19 Claude Sonnet 5.5 · medium
31.0 Score $0.23 2.2 min échoué Boucle fixe
-
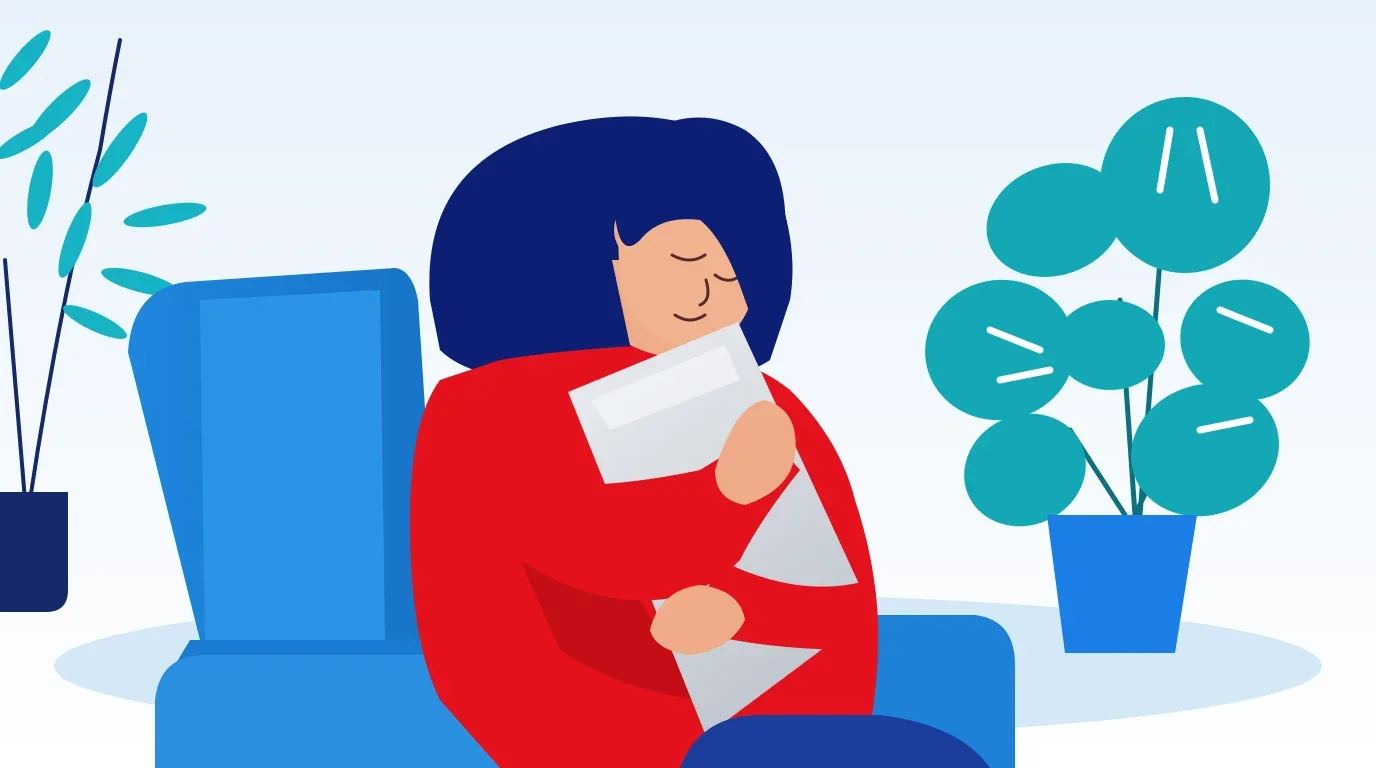
#20 Claude Haiku 5.5 · medium
32.6 Score $0.00 0.6 min échoué Single-shot
-
#21 Claude Sonnet 5.5 · medium
30.1 Score $0.04 0.5 min échoué Single-shot
-
#22 Arrow 2, Extra High
17.8 Score ≥ $0.22 non chronométré échoué Outil
-
Gemini 3.1 Pro · max Partiel : 1 image sur 2
46.7 Score ≤ $1.6 11 min passé Agentique
L'original contre Claude Opus 5.5 · max
Original Claude Opus 5.5 · max Zooms
Visage
Mains
Que montre l'édition 2026.10 du benchmark vectorisation ?
Dans le benchmark vectorisation de Samsa, édition 2026.10 (8 octobre 2026), Claude Opus 5.5 en effort max obtient le meilleur Samsa Vectorization Score, 82.1 sur 100, pour un coût médian de $43.5 sur l'image plate du laptop et de $60.2 sur l'image texturée du vélo électrique. Le classement repose sur 90 exécutions notées de 23 configurations, sur deux illustrations. Claude Opus 5.5 en effort max est une référence à une exécution par image.
- Parmi les modèles d'IA, seules les exécutions agentiques atteignent la parité visuelle. Une exécution est agentique quand le modèle travaille dans l'agent de code de son éditeur, rend son SVG, le compare à l'original et le corrige sur de nombreux tours. 31 exécutions agentiques sur 34 passent le seuil de parité et ses huit critères. Aucune des 48 exécutions en un seul appel ou en boucle fixe n'y arrive, quel que soit le modèle.
- Les outils de tracé copient les pixels et perdent les objets. vtracer et Vectorize de Recraft rendent bien les couleurs, et vtracer passe même le seuil de parité sur l'image plate du laptop. Les deux restent à 9 sur 100 ou moins en structure : sur le vélo, vtracer livre 9328 formes sans nom et Recraft 1462, chaque objet découpé selon ce qui en est visible.
- Le meilleur rapport score-prix ne vient pas de Claude. GPT 6.1 Sol en effort xhigh obtient 73.9, pour un coût médian de $6.8 et $9.1 par image. C'est 8.2 points de moins que la meilleure configuration pour environ 15 % de son coût, ce qui le place sur la ligne de frontière du graphique ci-dessus.
- Quiver AI dessine des objets, pas encore l'image. Arrow 2 Telos livre quelques grands objets groupés : son score de structure se situe entre les outils de tracé et les exécutions agentiques (58.1 sur le vélo). Sa fidélité reste loin du seuil de parité sur les deux images.
- Plus d'effort achète de la fidélité, cher. Claude Opus 5.5 en effort max atteint la meilleure fidélité de toutes les exécutions du protocole sur le vélo (71.8), pour $60.2 ; seule l'exécution exploratoire de l'essai A/B de Claude Fable 5.1 en xhigh, qui n'est pas une exécution propre du protocole, fait mieux (80.3, pour $117). Le graphique de l'effort plus bas montre à partir d'où un dollar de plus ne fait presque plus bouger le score.
Claude Fable 5.1 en effort xhigh, une référence à une exécution par image, échoue au seuil de parité sur l'image du laptop mais le passe sur le vélo et se classe 8e sur 22 avec 72.6, pour $42.9 et $117 par image. Son résultat sur le vélo est l'exécution exploratoire de l'essai A/B du 6 octobre 2026, pas une exécution propre du protocole (version antérieure du prompt, interrompue une fois puis reprise, travail délégué à des sous-agents) ; une répétition selon le protocole est en attente. Claude Haiku 5.5 figure dans cette édition en un seul appel, en effort medium : six exécutions, $0.04 pour l'ensemble, aucune à parité, un score global de 31.6. Ses variantes agentiques (xhigh et high) et l'hybride, un brouillon de GPT 6.1 Sol fini par Claude Opus 5.5 en effort high, tournent encore et seront ajoutés lors d'une mise à jour. Gemini 3.1 Pro a tourné une fois, sur l'image du laptop seulement, et obtient 46.7 : il figure comme participant partiel, sans rang global.
L'écart d'une exécution à l'autre
Une même configuration agentique sur la même image a varié jusqu'à 4.0 points d'une exécution à l'autre sur le vélo, et son coût jusqu'à 1.7 fois. Cela suffit pour intervertir deux voisins au classement. Les configurations qui comptent pour une décision produit ont donc tourné jusqu'à trois fois, et le classement indique n et l'écart pour chaque ligne qui a plus d'une exécution.
Pourquoi un SVG tracé échoue-t-il au test de structure ?
Un SVG tracé échoue parce qu'il décrit l'image comme des zones de couleur, pas comme des choses. Samsa a construit ce benchmark parce que ses clients demandent des fichiers éditables : déplacer le cycliste, changer la couleur de la veste, sortir le vélo de la scène. Dans un tracé, la jambe du fond n'existe que sous forme des bandes visibles entre le cadre et le pédalier, et le ciel se réduit à une douzaine de fragments autour des nuages. Rien n'a de nom, donc un designer ne retrouve rien.
Un SVG reconstruit, c'est ce qu'un illustrateur livrerait : des objets nommés dans un ordre de calques logique, chacun dessiné en entier, y compris les parties que d'autres objets cachent. C'est ce que le score de structure récompense, et c'est pourquoi la structure pèse 35 % à côté des 50 % de la fidélité. Un fichier qui a l'air juste mais qu'on ne peut pas retoucher ne remplit pas le rôle pour lequel on commande un fichier vectoriel.
Que signifient ces résultats si tu as besoin d'un SVG éditable ?
- Pour une icône ou un logo qui doit seulement s'agrandir, un outil de tracé suffit. C'est gratuit ou presque, et ça prend quelques secondes.
- Pour une illustration que tu veux retoucher, prévois une exécution agentique : $5.3–$60.2 de calcul et 31–128 minutes par image à ce niveau, pas quelques centimes et quelques secondes.
- Ne juge pas sur la miniature. Un fichier tracé et un fichier reconstruit peuvent se ressembler en taille réelle : ouvre les calques avant d'accepter l'un ou l'autre.
- Une exécution n'est qu'un échantillon. Si le résultat compte, lance-en deux et garde le meilleur fichier, ou prévois une reprise à la main des détails délicats : visages, mains, mécanique.
La méthode pas à pas, avec les contrôles qu'un fichier terminé doit passer, se trouve dans le guide vectoriser une image avec l'IA sans perdre l'éditabilité.
Citer ce benchmark
Samsa, « Benchmark vectorisation », édition 2026.10, 8 octobre 2026, samsa.ai/fr/benchmarks/vectorisation/. Les prompts, les prompts des juges et les métriques brutes de chaque exécution sont publiés avec le jeu de données.
Ce qu'apporte plus d'effort
Le même modèle à chaque niveau de raisonnement : comment le score bouge quand le coût par image monte.
- GPT 6.1 Sol · medium → high → xhigh
- Claude Sonnet 5.5 · high → xhigh
- Claude Opus 5.5 · medium → high → xhigh → max
Détail de la structure
Les contrôles automatiques de structure par participant, modèles et outils ensemble. Un tiret est un contrôle que cette édition n'a pas exécuté.
Comment se déroule une exécution du benchmark ?
Chaque participant reçoit le même prompt figé et les mêmes images, selon le protocole 1.0.1. Une exécution est une nouvelle session dans l'agent de l'éditeur, avec le prompt pour seule entrée et aucun message en cours de route. Elle itère jusqu'à ce que le seuil de parité soit passé et la revue des détails propre, ou jusqu'à une limite de trois heures ou 25 tours notés, puis laisse son meilleur état.
- Un agent par éditeur, déclaré. Les modèles Claude tournent dans Claude Code 2.1.291 (Haiku 5.5 dans la 2.1.294, première version qui connaît ce modèle), GPT 6.1 Sol dans Codex CLI 0.160.0 en fast tier, Gemini dans Gemini CLI 0.62.0 avec une clé API. On mesure le modèle et son agent, et le classement nomme les deux.
- Les exécutions interrompues sont écartées et refaites. Une exécution arrêtée de l'extérieur (limite d'usage, processus tué, erreur réseau) n'est pas notée, et son coût n'apparaît nulle part. La reprise reçoit le numéro suivant.
- Les sous-agents sont autorisés quand l'agent en propose. Leurs tokens comptent, et le jeu de données indique que l'exécution a délégué.
- Une machine, une boîte à outils. Toutes les exécutions agentiques tournent sur le même Mac, et les outils de notation sont figés par empreinte et ne changent jamais en cours d'édition.
Quelles sont les quatre catégories ?
La catégorie dit comment un participant a produit son SVG. Le graphique dessine chacune avec son propre marqueur, et le classement l'affiche en colonne.
| Catégorie | Comment le SVG est produit | Qui en fait partie |
|---|---|---|
| Agentique | Le modèle travaille dans l'agent de son éditeur, écrit et lance du code, rend et compare son SVG, et itère dans les limites. | Claude Fable, Opus et Sonnet, GPT 6.1 Sol et Gemini 3.1 Pro ; Claude Haiku et l'hybride Sol + Opus arrivent avec une mise à jour |
| Un seul appel | Un appel avec l'image et le prompt, sans outils. La réponse est le SVG. | Claude Opus, Sonnet, Fable et Haiku, GPT 6.1 Sol |
| Boucle fixe | Quatre tours où le modèle voit son rendu et le retour de parité et réécrit le SVG, sans outils. Le meilleur tour compte. | Claude Opus 5.5 et Sonnet 5.5 |
| Outil | Le résultat d'un outil de vectorisation, noté comme n'importe quel SVG. | Recraft Vectorize, Quiver AI Arrow 2 et Arrow 2 Telos, vtracer |
Quelles images composent la suite ?
Deux illustrations créées avec Samsa, une par niveau de difficulté. Chacune a son inventaire : la liste des objets qu'une vectorisation complète doit contenir, rédigée par Samsa et figée pour l'édition.
- Laptop, niveau 1 (aplat) : aplats de couleur, aucune texture, formes organiques qui se chevauchent, un visage et des mains. 1376 × 768 pixels, 32 objets à l'inventaire.
- Vélo électrique, niveau 2 (texturé) : grain argentique, pointillé, dégradés, 56 rayons, un visage, des zones masquées derrière la jambe du fond et le pédalier. 2400 × 1792 pixels, 53 objets à l'inventaire.
- Une scène de niveau 3 est prévue pour une édition ultérieure.
Comment une exécution est-elle notée ?
Chaque exécution reçoit trois sous-scores de 0 à 100, combinés en Samsa Vectorization Score. La note d'un participant par image est la médiane de ses exécutions, son rang global la moyenne de ces médianes. Un participant mesuré sur une seule image est listé comme partiel, sans rang global. Le coût et la durée sont des axes à côté du score, jamais dedans.
| Partie | Poids | Ce qu'elle mesure |
|---|---|---|
| Fidélité | 50 % | Écart de couleur moyen, similarité structurelle, la pire fenêtre locale et, sur le vélo, la correspondance du grain, par rapport à l'original, les deux images posées sur fond blanc. Le seuil de parité à huit critères s'affiche comme un badge et n'entre pas dans le score. |
| Structure | 35 % | 60 % automatique : calques nommés, couverture de l'inventaire, complétude des formes masquées et économie des tracés, avec des pénalités pour les images matricielles intégrées, les masques d'écrêtage qui simulent l'occlusion et les transformations figées. 40 % jugé : sens des objets, complétude sous occlusion, éditabilité, ordre des calques et qualité des tracés. |
| Détail | 15 % | Deux zooms standard par image (visage et mains sur le laptop, visage et transmission sur le vélo), jugés face au même zoom de l'original pour la ressemblance et la qualité d'exécution. |
Les parties jugées viennent de deux modèles de vision d'éditeurs différents, Claude Opus 5.5 et GPT 6.1 Sol, qui voient des résultats anonymisés et mélangés. Leurs prompts sont publiés avec les résultats.
Comment le coût et la durée sont-ils comptés ?
- Le coût est un équivalent API : les tokens d'une exécution par classe (entrée, sortie raisonnement compris, écriture et lecture du cache), multipliés par le prix catalogue de l'éditeur le jour de l'exécution. Le relevé de prix est conservé avec chaque exécution (6 au 9 octobre 2026). C'est ce que l'exécution coûterait via l'API, pas une facture.
- Les exécutions Codex en fast tier enregistrent le coût fast tier et l'équivalent standard. Haiku 5.5 est facturé par requête selon ses deux grilles de prix liées à la longueur du prompt.
- Un outil compte à son prix publié par conversion, et sa durée vient d'un essai chronométré.
- La durée est le temps réel entre le lancement de l'agent et son rapport final.
- Les lignes à plusieurs exécutions affichent la médiane et l'écart. Une ligne à une seule exécution n'affiche que la valeur, car une exécution n'a pas d'écart.
Qu'a changé le protocole 1.0.1 ?
Les résultats dont le canevas diffère de l'original sont désormais alignés sur leur contenu, plus sur leur cadre. Le noteur rend le SVG, prend le cadre englobant de ce qu'il a dessiné, le pose sur le cadre du contenu de l'original avec une seule échelle et complète en transparence. Si les proportions des deux cadres diffèrent de plus de 10 %, c'est tout le canevas qui est ajusté. La règle vaut pour tous les participants. Elle a été ajoutée parce que les exports de Quiver AI ont une marge d'environ 2,4 % qui leur faisait perdre presque toute leur fidélité avec l'ancienne règle : un défaut de cadrage, pas de vectorisation.
Quelles sont les limites ?
- Deux images. Le classement dit comment les participants gèrent une illustration en aplats et une illustration texturée, pas des photos, des logos ou des dessins techniques.
- Modèle et agent. Chaque modèle tourne dans l'agent de son éditeur, donc l'agent fait partie de la mesure. Une catégorie indépendante de l'agent pourra suivre.
- Exécutions uniques là où c'est indiqué. Claude Fable 5.1 en xhigh et Claude Opus 5.5 en max sont des références à une exécution par image, à cause de leur coût, et les niveaux d'effort inférieurs n'ont tourné qu'une fois. Gemini 3.1 Pro a tourné une fois, sur le laptop, avec un plafond API de 20 $. Claude Opus 5.5 en effort high compte pour l'instant trois exécutions sur le laptop et deux sur le vélo, et Claude Sonnet 5.5 en xhigh deux sur le vélo ; leurs troisièmes exécutions sur le vélo sont en cours et seront ajoutées lors d'une mise à jour. Un résultat n'est pas une exécution propre du protocole : Claude Fable 5.1 en effort xhigh sur le vélo. Des limites d'utilisation ont interrompu deux fois son exécution du protocole ; son exécution exploratoire de l'essai A/B du 6 octobre 2026 la remplace donc, exécutée avec une version antérieure du prompt (sans les plafonds), interrompue une fois puis reprise, avec du travail délégué à des sous-agents, sur Claude Code 2.1.290. Elle est classée comme tout autre résultat, signalée partout où elle apparaît, et sera remplacée par une répétition selon le protocole.
- Le contrôle de complétude seul favorise les grands objets peu nombreux, et c'est ainsi que dessine Arrow 2 Telos. Le score de structure dans son ensemble classe quand même les fichiers reconstruits devant Telos et Telos devant les tracés, mais lis ce sous-score en le sachant.
- Les juges sont des modèles. Ils voient des résultats anonymisés et leurs prompts sont publiés, mais ce ne sont pas des designers. Samsa vérifie les zooms à la main avant publication.
- Samsa s'appuie sur des modèles d'Anthropic, et l'un des deux juges est un modèle d'OpenAI. Le score de fidélité et la moitié automatique du score de structure se passent de juge, et chaque métrique brute est publiée pour que le résultat puisse être vérifié.
Comment proposer un modèle ou un outil ?
Lance le prompt figé sur les deux images selon le protocole, ou, pour un outil, envoie les SVG des deux images avec le prix et un essai chronométré. Samsa les note avec les mêmes outils et les ajoute à la prochaine mise à jour. Écris-nous pour en proposer un.
Journal des modifications
-
Claude Fable 5.1 en xhigh a désormais un résultat sur le vélo électrique : son exécution exploratoire de l'essai A/B du 6 octobre 2026 remplace l'exécution du protocole, interrompue deux fois par des limites d'utilisation. C'est le seul résultat de cette édition qui n'est pas une exécution propre du protocole (version antérieure du prompt, interrompue une fois puis reprise, travail délégué à des sous-agents) ; il est signalé partout où il apparaît, et une répétition selon le protocole est en attente. Également ajoutés : Recraft sur l'image de l'ordinateur portable, une troisième exécution de Claude Opus 5.5 en high sur l'ordinateur portable, et le coût des outils (Recraft au prix catalogue, Quiver en borne inférieure).
-
Édition publiée.
Questions fréquentes : benchmark vectorisation
Que mesure le benchmark vectorisation ?
Une seule tâche : transformer une illustration matricielle en SVG qu'un designer peut retoucher. Chaque exécution est notée sur la fidélité à l'original (50 %), la structure, c'est-à-dire des calques nommés, complets et économes (35 %), et le détail des zones clés comme les visages et les mains (15 %). La somme pondérée donne le Samsa Vectorization Score. Le coût et la durée par image restent à côté et ne le modifient jamais.
Quelle IA vectorise le mieux une illustration ?
Dans l'édition 2026.10, Claude Opus 5.5 en effort max arrive en tête avec 82.1, devant Claude Sonnet 5.5 en effort xhigh (79.5). GPT 6.1 Sol en effort xhigh obtient 73.9 pour une fraction du coût. Toutes les configurations de tête ont tourné comme agent qui rend et corrige son propre SVG ; aucun prompt unique, à aucun modèle, n'en approche.
Un seul prompt à un modèle IA peut-il transformer une image en SVG éditable ?
Pas à parité, dans ce benchmark. Les appels uniques à des modèles Claude et GPT livrent en quelques minutes des SVG propres et bien nommés, pour quelques centimes à environ un dollar. Mais aucune des 48 exécutions en un seul appel ou en boucle fixe ne passe le seuil de parité : ce sont des versions stylisées de l'image, pas des copies. Montrer son rendu au modèle pendant quatre tours ne comble pas l'écart. La parité demande un agent qui mesure et corrige.
Pourquoi les outils de tracé ont-ils une note basse alors que leur SVG a l'air juste ?
Parce qu'avoir l'air juste ne fait que la moitié du travail. Un outil de tracé découpe l'image en aplats par couleur : sur le vélo, vtracer a produit 9328 formes sans nom. La fidélité est élevée, mais aucune forme n'est un objet et toutes les parties cachées manquent. Le score de structure, 35 % du total, mesure exactement ce dont un designer a besoin pour retoucher le fichier, et les outils de tracé en perdent presque tout.
Comment le benchmark compte-t-il le coût et la durée ?
Le coût correspond aux tokens d'une exécution multipliés par le prix catalogue de l'éditeur le jour même, par classe de tokens, avec le relevé de prix conservé. C'est un équivalent API, pas une facture. Un outil compte à son prix publié par conversion. La durée court du lancement au rapport final. Les deux sont des médianes sur les exécutions d'un participant, avec l'écart quand il y en a plusieurs.
Le benchmark vectorisation est-il indépendant ?
Aucun benchmark mené par une entreprise n'est totalement indépendant, et Samsa s'appuie sur des modèles d'Anthropic. Ce qui le rend vérifiable : un prompt figé pour tous, une notation automatique de la fidélité, deux juges d'éditeurs différents sur des résultats anonymisés, des prompts de juges publiés et chaque métrique brute publiée avec son exécution. Chacun peut refaire le protocole et comparer.
Puis-je proposer un modèle ou un outil ?
Oui. Lance le prompt figé sur les deux images selon le protocole, ou envoie les SVG d'un outil pour les deux images avec son prix et un essai chronométré. Samsa note la proposition avec les mêmes outils et l'ajoute à la prochaine mise à jour. Passe par la page de contact pour nous écrire.
À quelle fréquence le benchmark est-il mis à jour ?
Dès qu'un modèle ou un outil pertinent sort. Les lignes s'ajoutent et ne sont jamais modifiées : un participant mesuré à nouveau reçoit une nouvelle édition, les relevés de prix restent avec leurs exécutions, et le journal des modifications de cette page date chaque changement. Claude Haiku 5.5, sorti pendant les exécutions de l'édition 2026.10, l'a rejointe ainsi.
Crée des images fidèles à ta marque, exportées en SVG
Le générateur d'images de Samsa apprend ta marque. Télécharge tes images en SVG à calques et transmets-les à tes designers.